
TabPFN: mô hình nền tảng cho dữ liệu dạng bảng hoạt động như thế nào
Phân tích TabPFN từ bài toán, lịch sử phát triển, ý tưởng suy luận Bayes bằng Transformer, dữ liệu huấn luyện tổng hợp từ mô hình nhân quả cấu trúc, kiến trúc attention hai chiều, quy trình suy luận, kết quả benchmark trên Nature 2025 và TabArena, đến các ứng dụng và giới hạn khi dùng trong thực tế.
Giả sử bạn có một file CSV gồm 400 bệnh nhân, mỗi người có 12 chỉ số xét nghiệm và một cột cho biết họ có mắc bệnh tim hay không. Quy trình quen thuộc là chọn XGBoost hoặc CatBoost, chia dữ liệu, chạy tìm kiếm siêu tham số (hyperparameter search) với cross-validation, đợi vài chục phút đến vài giờ, rồi chọn cấu hình có điểm validation cao nhất. Khi nhận bộ dữ liệu thứ hai, toàn bộ quá trình này lặp lại từ đầu. Mô hình của bộ thứ nhất không giúp gì cho bộ thứ hai.
TabPFN bỏ bước huấn luyện theo từng bộ dữ liệu. Nhóm tác giả huấn luyện một Transformer duy nhất trên khoảng 130 triệu bộ dữ liệu tổng hợp. Khi gặp bộ dữ liệu thật, mô hình nhận toàn bộ tập huấn luyện làm ngữ cảnh đầu vào và đưa ra dự đoán cho tập kiểm thử trong một lượt lan truyền xuôi (forward pass), không cập nhật trọng số.
Phiên bản thứ hai của mô hình được công bố trên tạp chí Nature vào tháng 1/2025 với tiêu đề Accurate predictions on small data with a tabular foundation model, do Noah Hollmann, Samuel Müller, Frank Hutter cùng các cộng sự tại Đại học Freiburg thực hiện. Mã nguồn được công bố tại https://github.com/PriorLabs/TabPFN.
Bài viết này đi qua từng phần của TabPFN: bài toán nó giải quyết, ý tưởng toán học phía sau, cách sinh dữ liệu huấn luyện, kiến trúc mạng, cách suy luận, kết quả đánh giá và những trường hợp không nên dùng nó.
1. Dữ liệu dạng bảng và vấn đề của dữ liệu nhỏ
1.1. Bảng có mặt ở hầu hết các lĩnh vực
Hồ sơ bệnh án, lịch sử giao dịch ngân hàng, số đo cảm biến trong nhà máy, kết quả thí nghiệm hóa học đều được lưu dưới dạng bảng: mỗi hàng là một mẫu (sample), mỗi cột là một đặc trưng (feature), và thường có một cột mục tiêu (target) cần dự đoán. Nếu cột mục tiêu là nhãn rời rạc (có bệnh hay không), ta có bài toán phân loại (classification). Nếu là số thực (giá nhà, liều thuốc), ta có bài toán hồi quy (regression).
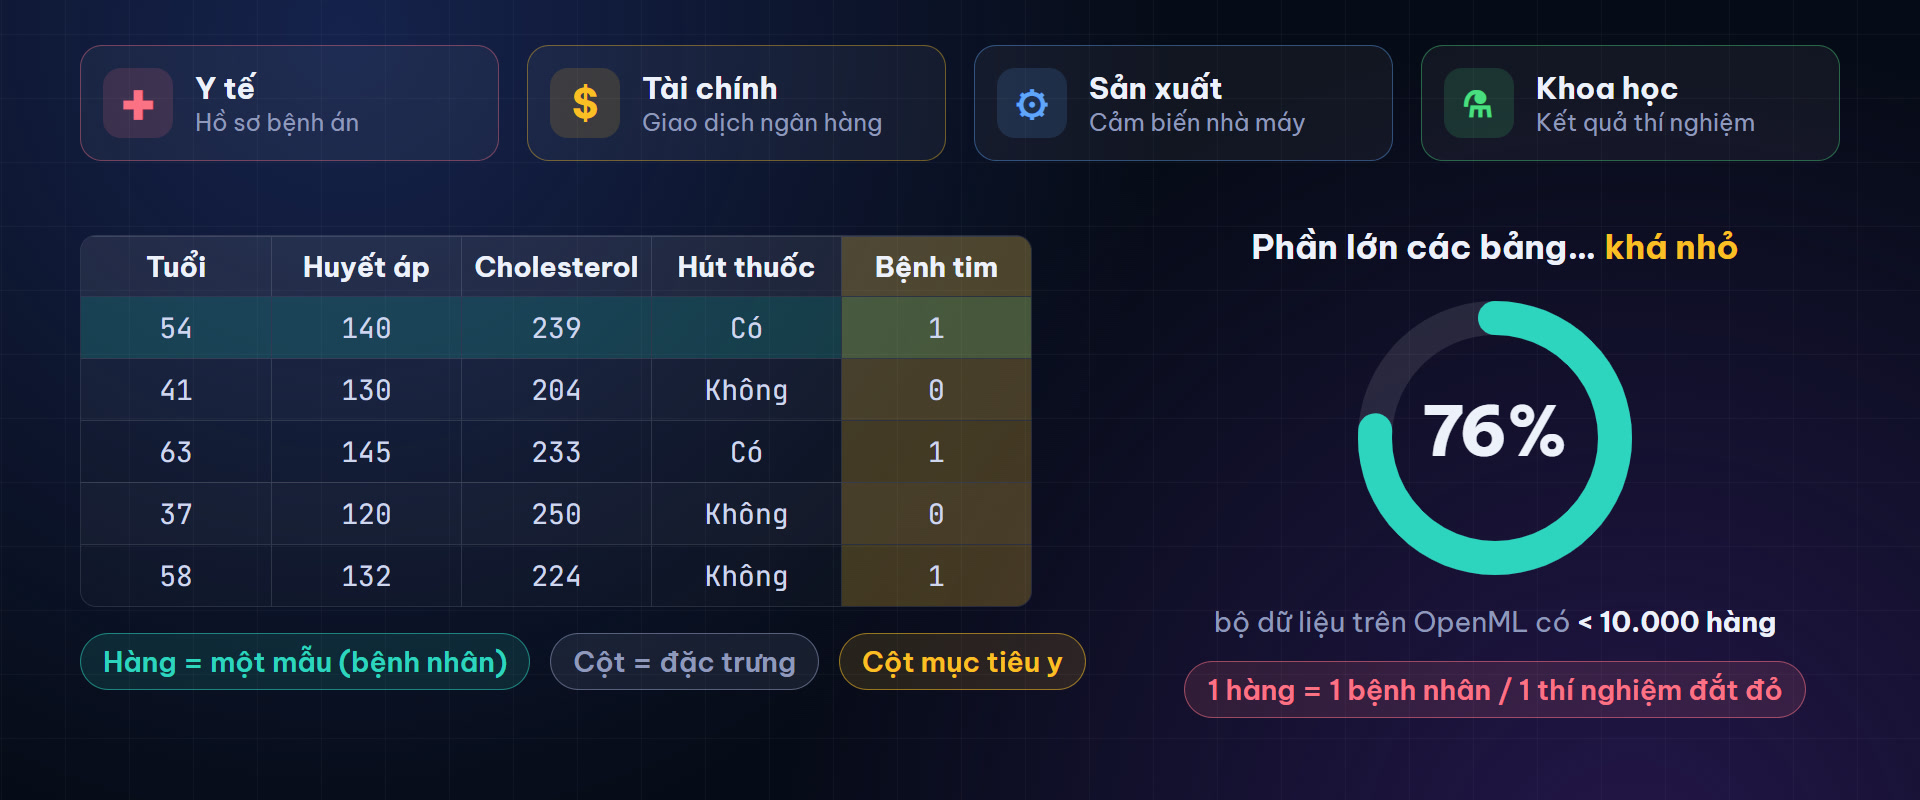
Hình 1. Một bảng dữ liệu y tế: mỗi hàng là một bệnh nhân, mỗi cột là một chỉ số, cột cuối là nhãn cần dự đoán. Trên OpenML, khoảng 76% bộ dữ liệu có ít hơn 10.000 hàng (số liệu do Hollmann et al. thống kê tại thời điểm viết bài).
Phần lớn các bảng trong thực tế khá nhỏ. Theo thống kê trong bài báo Nature, khoảng 76% bộ dữ liệu trên OpenML có dưới 10.000 hàng. Lý do nằm ở chi phí thu thập: một hàng có thể tương ứng với một bệnh nhân tham gia nghiên cứu lâm sàng, một mẫu vật liệu phải tổng hợp trong phòng thí nghiệm, hoặc một lần chạy thử nghiệm trên dây chuyền sản xuất. Với những bộ dữ liệu cỡ này, thêm hay bớt vài trăm hàng đã làm kết quả thay đổi, nên hiệu quả sử dụng dữ liệu của phương pháp ảnh hưởng trực tiếp đến chất lượng dự đoán.
1.2. Vì sao deep learning chưa thay thế được mô hình cây
Trong khoảng mười năm qua, deep learning đã trở thành phương pháp mặc định cho ảnh, âm thanh và văn bản, nhưng với dữ liệu bảng thì chưa. Nghiên cứu Why do tree-based models still outperform deep learning on tabular data? (Grinsztajn et al., NeurIPS 2022) cho thấy trên các bộ dữ liệu cỡ vừa, các mô hình cây như Random Forest và XGBoost vẫn cho kết quả tốt hơn các mạng nơ-ron được thiết kế riêng cho bảng.
Một số đặc điểm của dữ liệu bảng gây khó cho mạng nơ-ron:
- Cột không đồng nhất: cùng một bảng có thể chứa số thực, số nguyên, giá trị nhị phân và biến danh mục (categorical), mỗi cột có thang đo riêng. Ảnh thì khác, mọi pixel có cùng ý nghĩa và cùng miền giá trị.
- Không có cấu trúc không gian: thứ tự các cột trong bảng là tùy ý. Phép tích chập (convolution) khai thác tính cục bộ của ảnh, nhưng hai cột đứng cạnh nhau trong bảng không nhất thiết liên quan đến nhau.
- Giá trị thiếu, ngoại lai và đặc trưng không có thông tin: dữ liệu thật thường chứa ô trống, giá trị nhập sai và các cột không liên quan đến mục tiêu. Mô hình cây xử lý những trường hợp này khá tự nhiên nhờ cách chia ngưỡng.
- Hàm mục tiêu không trơn: quan hệ giữa đặc trưng và nhãn trong bảng thường có dạng bậc thang hoặc ngưỡng, kiểu quan hệ mà cây quyết định biểu diễn dễ hơn mạng nơ-ron.
Vì vậy, họ mô hình cây tăng cường gradient (Gradient-Boosted Decision Trees) gồm XGBoost (2014), LightGBM (2017) và CatBoost (2017) vẫn là lựa chọn mặc định cho dữ liệu bảng.
1.3. Giới hạn của quy trình hiện tại
Quy trình dùng mô hình cây có ba điểm tốn kém:
- Huấn luyện lại cho mỗi bộ dữ liệu. Mỗi bộ dữ liệu mới bắt đầu từ trạng thái không có tri thức nào.
- Tinh chỉnh siêu tham số. Độ sâu cây, tốc độ học, số cây, tỉ lệ lấy mẫu con đều ảnh hưởng đến kết quả. Một vòng tìm kiếm ngẫu nhiên với cross-validation 5-fold có thể mất vài giờ.
- Không chuyển giao tri thức. Những gì học được từ hàng nghìn bộ dữ liệu trước đó, chẳng hạn quan hệ tuyến tính thường gặp hơn quan hệ dạng sin, hay đặc trưng có nhiều giá trị thiếu thường ít thông tin, không được dùng lại.
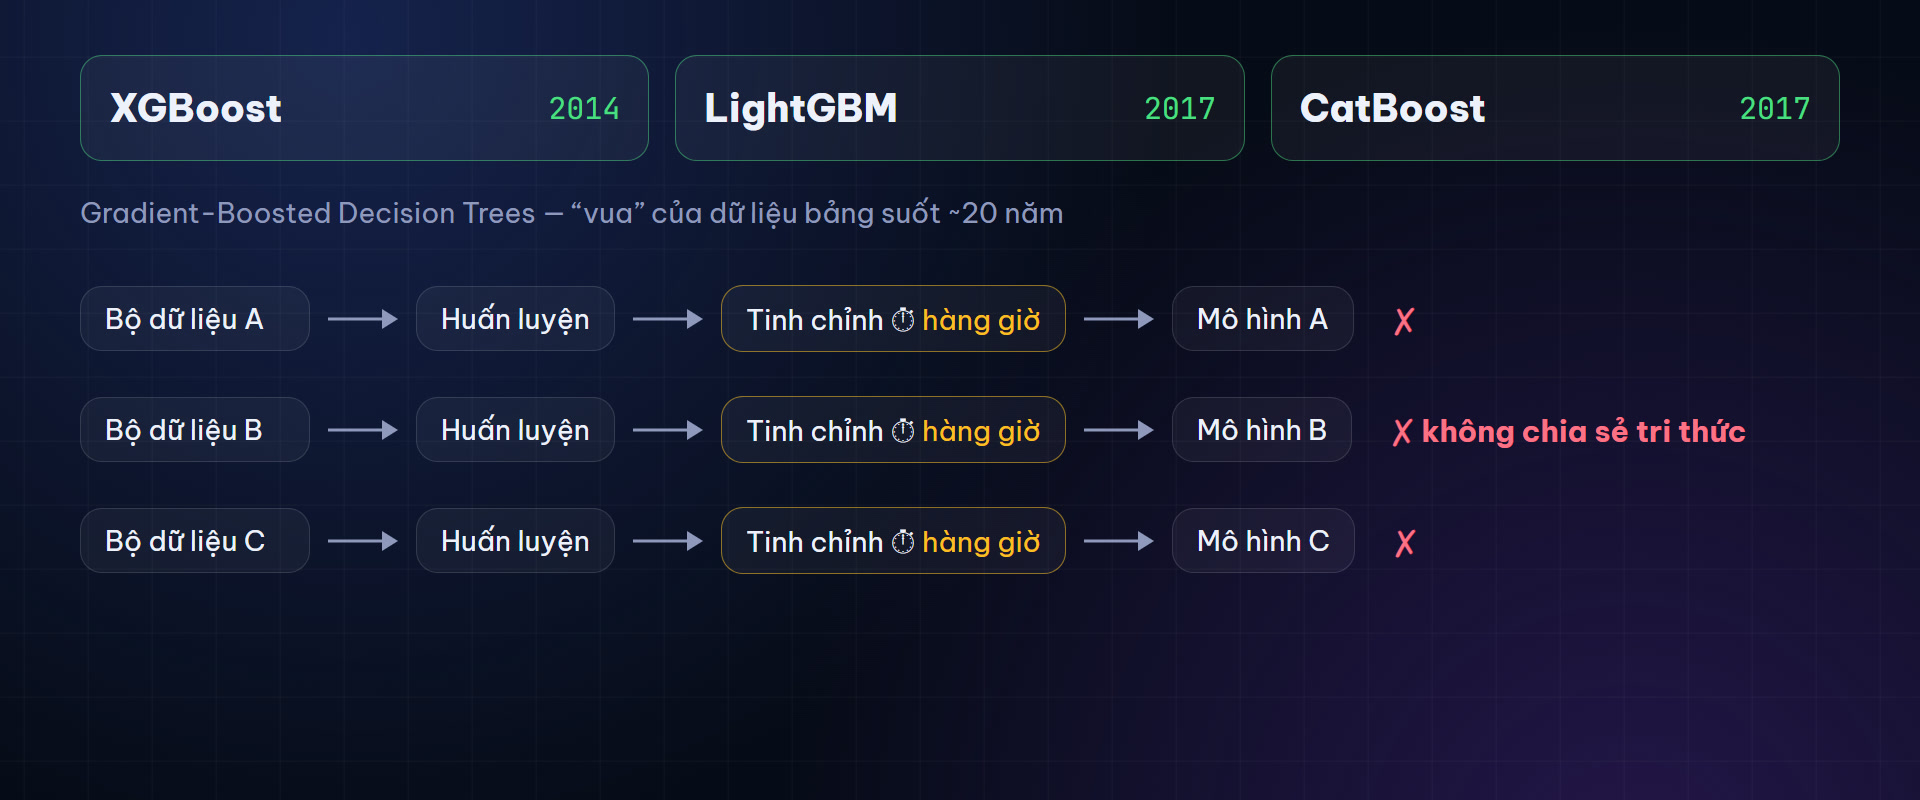
Hình 2. Với mô hình cây, mỗi bộ dữ liệu đi qua một quy trình huấn luyện và tinh chỉnh riêng. Kết quả của bộ này không dùng lại được cho bộ khác.
Trong xử lý ngôn ngữ, mô hình nền tảng (foundation model) được huấn luyện trước trên lượng văn bản lớn giải được nhiều tác vụ mới chỉ qua vài ví dụ trong prompt. TabPFN áp dụng cách làm đó cho dữ liệu bảng: huấn luyện trước một mô hình để khi nhận một bảng mới, nó dự đoán ngay mà không cần huấn luyện thêm.
2. Lịch sử phát triển
TabPFN được phát triển bởi nhóm nghiên cứu của GS. Frank Hutter tại Đại học Freiburg (Đức). Nhóm này trước đó làm về AutoML, tức tự động hóa việc chọn mô hình và siêu tham số, với các công cụ như Auto-sklearn. Hướng đi của TabPFN có thể xem là bước tiếp theo của AutoML: thay vì tự động hóa việc tìm cấu hình cho từng bộ dữ liệu, nhóm học một mô hình đã tích hợp sẵn quá trình đó.
- 2021: bài báo Transformers Can Do Bayesian Inference (Müller et al., ICLR 2022) giới thiệu khái niệm Prior-data Fitted Network (PFN): huấn luyện Transformer trên dữ liệu lấy mẫu từ một phân phối tiên nghiệm (prior) để xấp xỉ suy luận Bayes.
- 2022: TabPFN phiên bản 1 áp dụng ý tưởng PFN cho bảng, trình bày tại ICLR 2023. Phiên bản này giới hạn ở 1.000 mẫu huấn luyện, 100 đặc trưng số không có giá trị thiếu và 10 lớp, chỉ hỗ trợ phân loại. Thời gian dự đoán dưới 1 giây trên các bộ dữ liệu nhỏ.
- 2024: công ty Prior Labs được thành lập để phát triển và thương mại hóa TabPFN.
- 01/2025: TabPFN phiên bản 2 được công bố trên Nature. Giới hạn tăng lên 10.000 mẫu và 500 đặc trưng, bổ sung hồi quy, dữ liệu danh mục và giá trị thiếu.
- 11/2025: TabPFN-2.5 hướng tới bộ dữ liệu đến 50.000 mẫu và 2.000 đặc trưng.
- 05/2026: TabPFN-3 báo cáo khả năng xử lý 1 triệu hàng huấn luyện với 200 đặc trưng trên một GPU H100.
- 09/2026: theo Wikipedia, TabPFN-3.5 có khoảng 220 triệu tham số và dùng một mô hình chung cho cả phân loại và hồi quy.
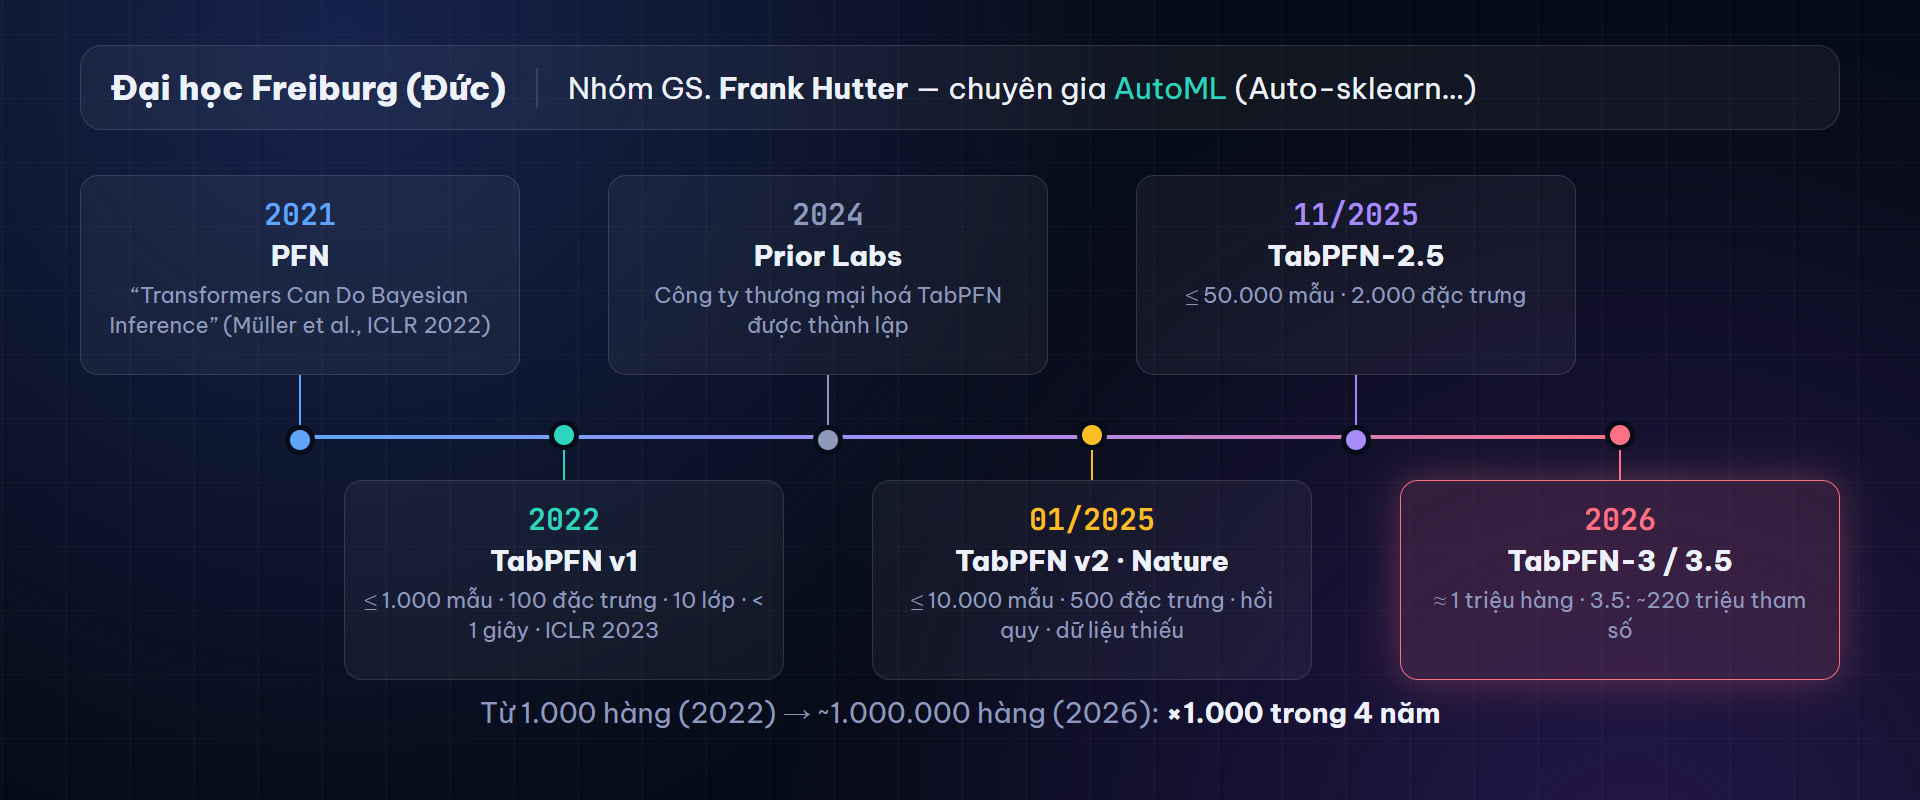
Hình 3. Các mốc phát triển của TabPFN. Kích thước dữ liệu được hỗ trợ tăng từ 1.000 hàng (2022) lên khoảng 1 triệu hàng (2026).
Phần lớn bài viết này tập trung vào phiên bản 2, vì đây là phiên bản được mô tả chi tiết nhất trong một bài báo đã qua bình duyệt. Các phiên bản sau giữ nguyên ý tưởng cốt lõi và chủ yếu thay đổi quy mô, tốc độ và dữ liệu huấn luyện.
3. Ý tưởng cốt lõi: học thuật toán học
3.1. Từ huấn luyện mô hình sang học trong ngữ cảnh
Một thuật toán học máy thông thường là một hàm nhận tập huấn luyện và trả về một mô hình. Mô hình này sau đó nhận và trả về dự đoán. TabPFN gộp hai bước lại: nó là một hàm nhận cùng lúc và , rồi trả về phân phối của .
Mô hình ngôn ngữ lớn cũng làm việc theo kiểu này, gọi là học trong ngữ cảnh (in-context learning). Khi ta đưa vào prompt vài cặp câu tiếng Anh và bản dịch tiếng Việt rồi thêm một câu mới, mô hình dịch câu mới dựa trên các ví dụ mà không cập nhật trọng số. Với TabPFN, các hàng đã có nhãn là phần ví dụ trong prompt, các hàng cần dự đoán là phần câu hỏi.
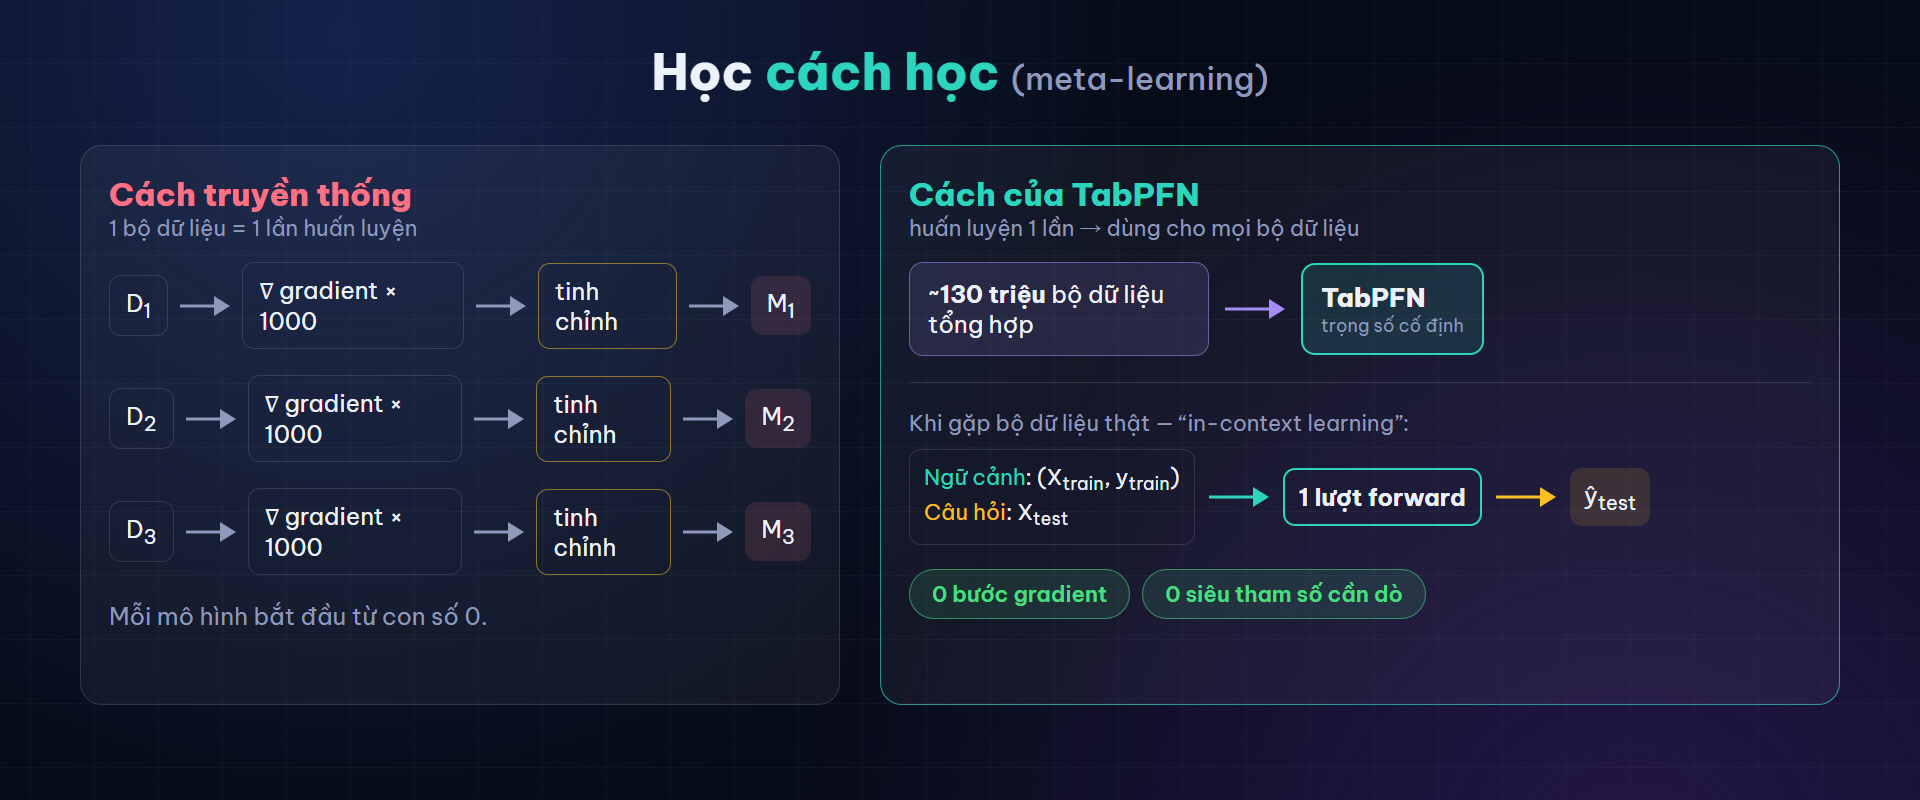
Hình 4. Bên trái: mỗi bộ dữ liệu được huấn luyện và tinh chỉnh riêng. Bên phải: TabPFN được huấn luyện một lần trên dữ liệu tổng hợp, sau đó dự đoán cho bộ dữ liệu mới bằng một lượt forward với trọng số cố định.
Quá trình "học" của TabPFN diễn ra ở hai cấp độ. Ở cấp ngoài, trong giai đoạn huấn luyện trước (pre-training), mạng học một thuật toán dự đoán từ hàng triệu bộ dữ liệu. Ở cấp trong, khi gặp một bộ dữ liệu cụ thể, thuật toán đã học được thực thi bên trong một lượt forward. Hàm fit() trong thư viện TabPFN vì thế không chạy vòng lặp tối ưu nào, nó chỉ lưu dữ liệu (và tính trước một số biểu diễn để tái sử dụng).
3.2. Liên hệ với suy luận Bayes
Thuật toán mà mạng học được có thể mô tả bằng suy luận Bayes. Giả sử dữ liệu được sinh ra bởi một cơ chế nào đó, ví dụ một hàm phi tuyến cộng nhiễu. Ta không biết , nhưng có một niềm tin ban đầu về những cơ chế có thể xảy ra, biểu diễn bằng phân phối tiên nghiệm . Sau khi quan sát tập huấn luyện, dự đoán tối ưu theo Bayes cho một điểm mới là phân phối dự đoán hậu nghiệm (Posterior Predictive Distribution, PPD):
Công thức này lấy trung bình dự đoán của mọi cơ chế có thể, có trọng số theo mức độ mỗi cơ chế phù hợp với dữ liệu đã thấy. Với prior đơn giản như hồi quy tuyến tính có nhiễu Gauss, tích phân có lời giải dạng đóng. Với prior phức tạp, ví dụ "dữ liệu được sinh bởi một đồ thị nhân quả ngẫu nhiên với các hàm phi tuyến ngẫu nhiên trên cạnh", tích phân trên không thể tính trực tiếp, và các phương pháp xấp xỉ như MCMC sẽ rất chậm.
Bài báo PFN năm 2021 đề xuất xấp xỉ tích phân này bằng học có giám sát. Nếu ta có thể lấy mẫu từ prior, ta có thể sinh ra số lượng tùy ý các bộ dữ liệu và huấn luyện một mạng để dự đoán bằng hàm mất mát log-likelihood âm:
Hàm mất mát này bằng kỳ vọng của độ phân kỳ KL giữa PPD thật và , cộng với một hằng số không phụ thuộc . Do đó, khi đạt cực tiểu, tiến tới PPD dưới prior đã chọn: mạng thực hiện suy luận Bayes cho prior đó bằng một lượt forward, không cần tính tích phân.
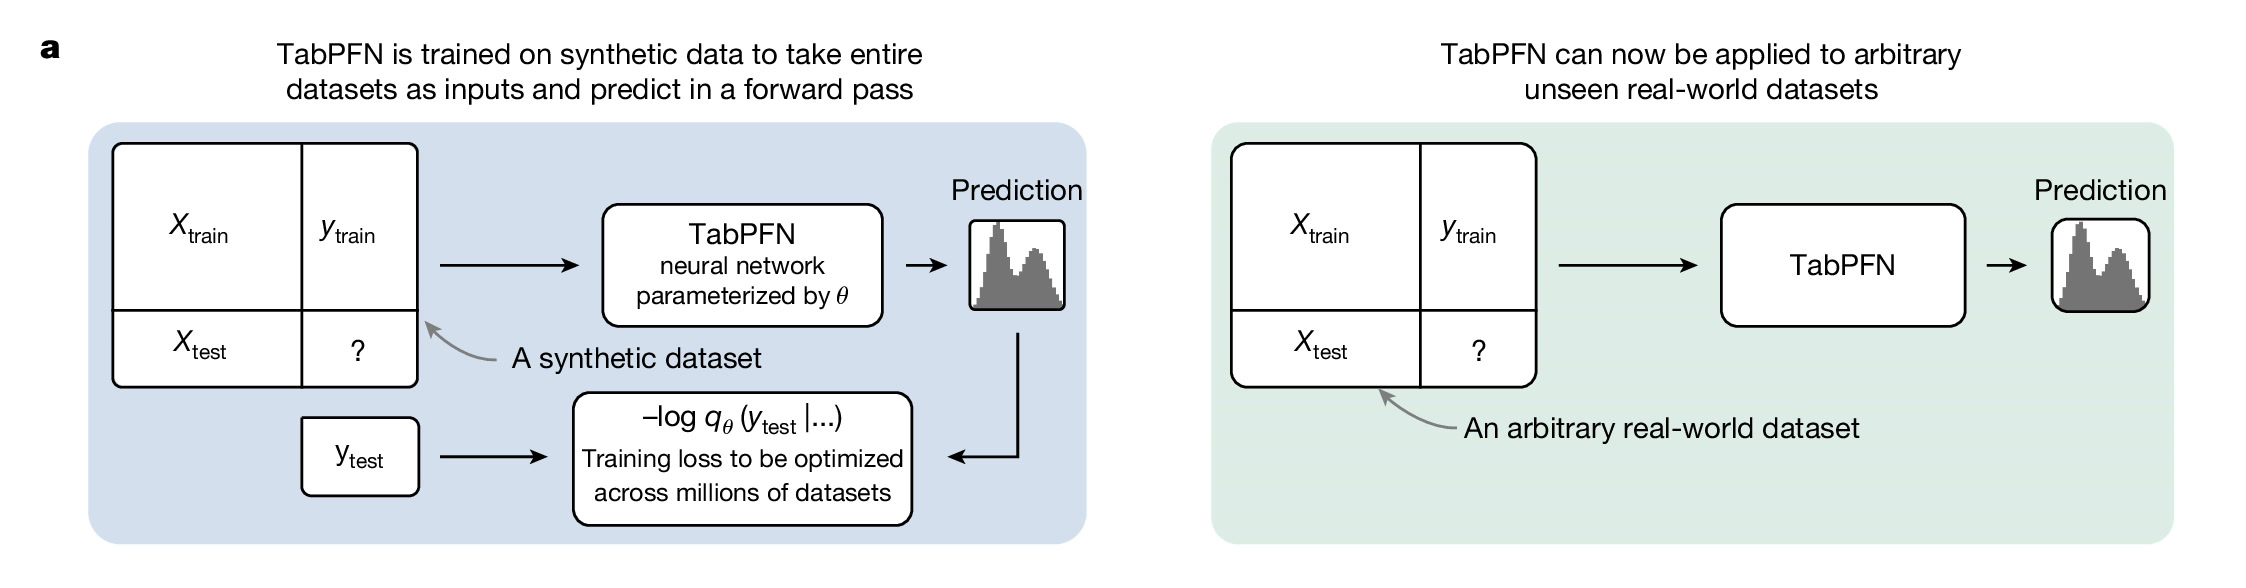
Hình 5. Bên trái: TabPFN được huấn luyện trên bộ dữ liệu tổng hợp, nhận toàn bộ bảng làm đầu vào và tối ưu hàm mất mát $-\log q_\theta(y_{test} \mid \dots)$ trên hàng triệu bộ dữ liệu. Bên phải: mô hình đã huấn luyện được áp dụng cho bộ dữ liệu thật chưa từng thấy. Nguồn: Hollmann et al., Nature 637 (2025), Fig. 1a, giấy phép CC BY 4.0.
Vì vậy chất lượng của TabPFN phụ thuộc trực tiếp vào prior. Nếu prior bao phủ tốt các kiểu quan hệ xuất hiện trong dữ liệu thật, mô hình sẽ dự đoán tốt trên dữ liệu thật. Phần lớn công sức của nhóm tác giả vì vậy dồn vào việc thiết kế prior, được mô tả ở mục 5.
4. Đầu vào và đầu ra
4.1. Định dạng đầu vào
Đầu vào của TabPFN gồm ba phần: ma trận đặc trưng , vector nhãn , và ma trận chứa các hàng cần dự đoán. Ba phần này được ghép thành một bảng duy nhất, trong đó ô nhãn của các hàng kiểm thử để trống.
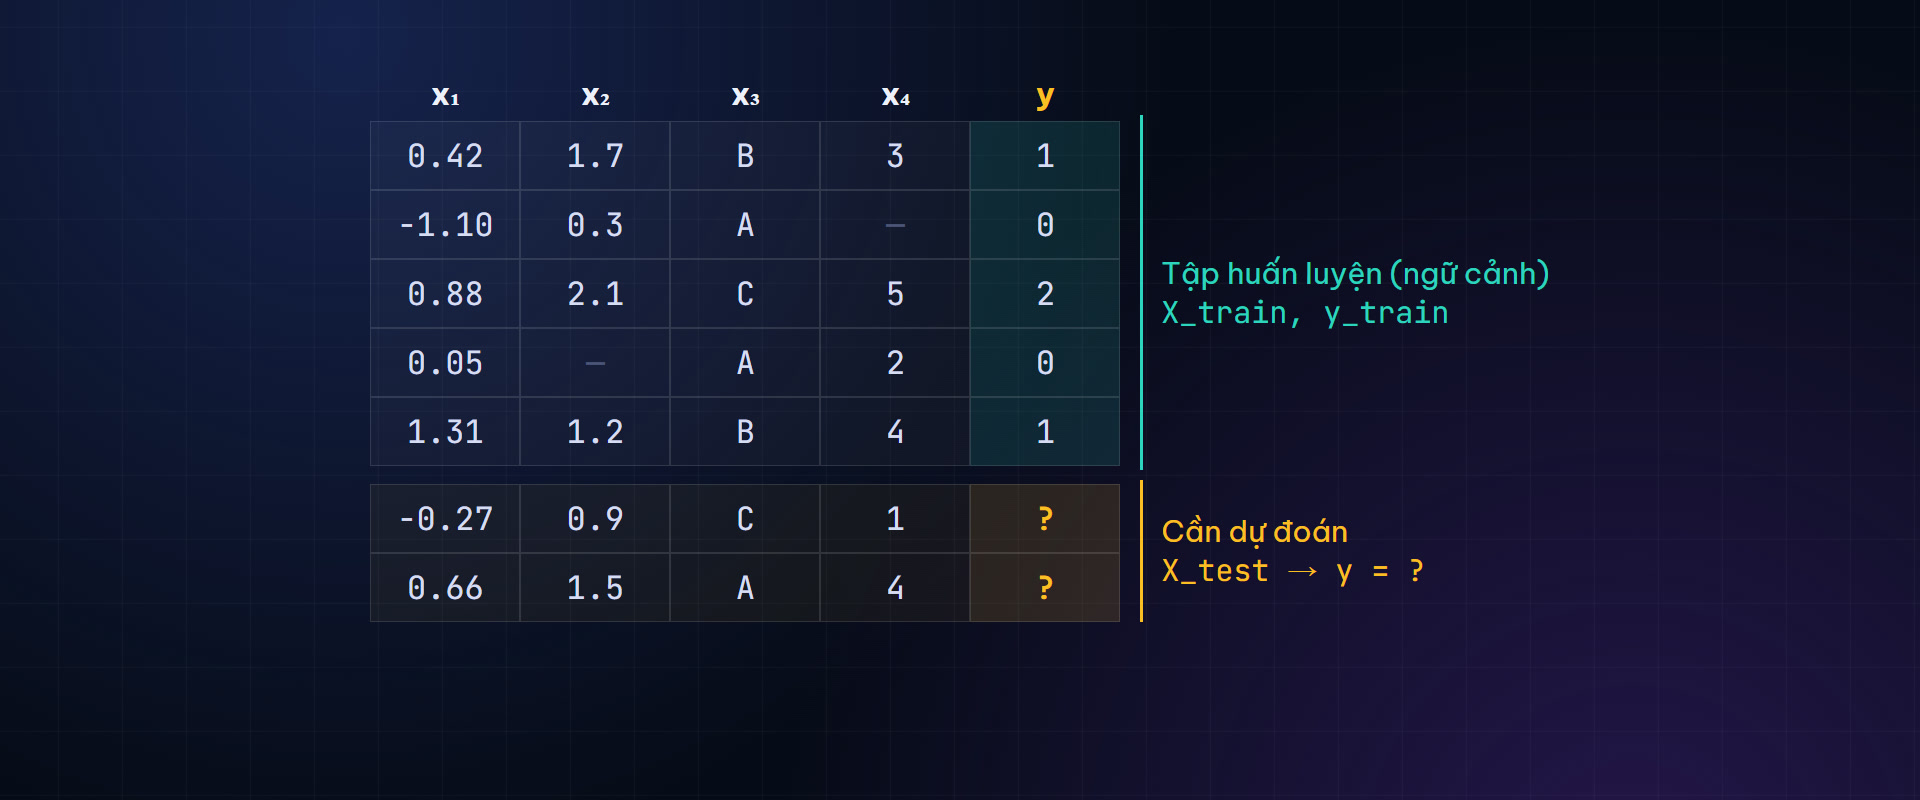
Hình 6. Tập huấn luyện và tập kiểm thử được ghép thành một bảng. Cột x₃ là biến danh mục, dấu gạch ngang là giá trị thiếu. TabPFN v2 chấp nhận cả hai loại dữ liệu này mà không cần tiền xử lý thủ công.
Với phiên bản 2, bài báo đánh giá trên bộ dữ liệu tối đa 10.000 mẫu, 500 đặc trưng và 10 lớp. Giới hạn 10 lớp đến từ prior: khi sinh dữ liệu tổng hợp cho bài toán phân loại, nhóm tác giả chỉ tạo nhãn với tối đa 10 lớp, nên mô hình chưa từng thấy bài toán nhiều lớp hơn. Thư viện có các công cụ mở rộng (TabPFN Extensions) để xử lý trường hợp nhiều lớp hơn bằng cách chia nhỏ bài toán.
4.2. Đầu ra cho phân loại
Với phân loại, đầu ra là phân phối xác suất trên các lớp, tính bằng softmax. Mặc định, TabPFN v2 dùng nhiệt độ để hiệu chỉnh độ tự tin của xác suất. Vì mạng được huấn luyện để xấp xỉ PPD, xác suất đầu ra có thể dùng trực tiếp như mức độ tin cậy, không chỉ để chọn lớp có xác suất cao nhất.
4.3. Đầu ra cho hồi quy: phân phối thay vì một con số
Với hồi quy, TabPFN không trả về một giá trị duy nhất mà trả về cả một phân phối, gọi là bar distribution hay phân phối Riemann. Miền giá trị của được chia thành nhiều khoảng (bin); biên các khoảng được lấy từ các phân vị 1/5.000 của giá trị mục tiêu trong dữ liệu prior. Mạng dự đoán xác suất cho từng khoảng, giống một bài toán phân loại với vài nghìn lớp. Hai đầu phân phối được nối thêm đuôi dạng half-normal để có giá trị ở toàn bộ trục số.
Từ phân phối này có thể suy ra trung bình, trung vị, mode và các phân vị. Cách biểu diễn này cũng mô tả được phân phối nhiều đỉnh, trường hợp mà hồi quy thông thường (dự đoán một giá trị trung bình) không mô tả được.
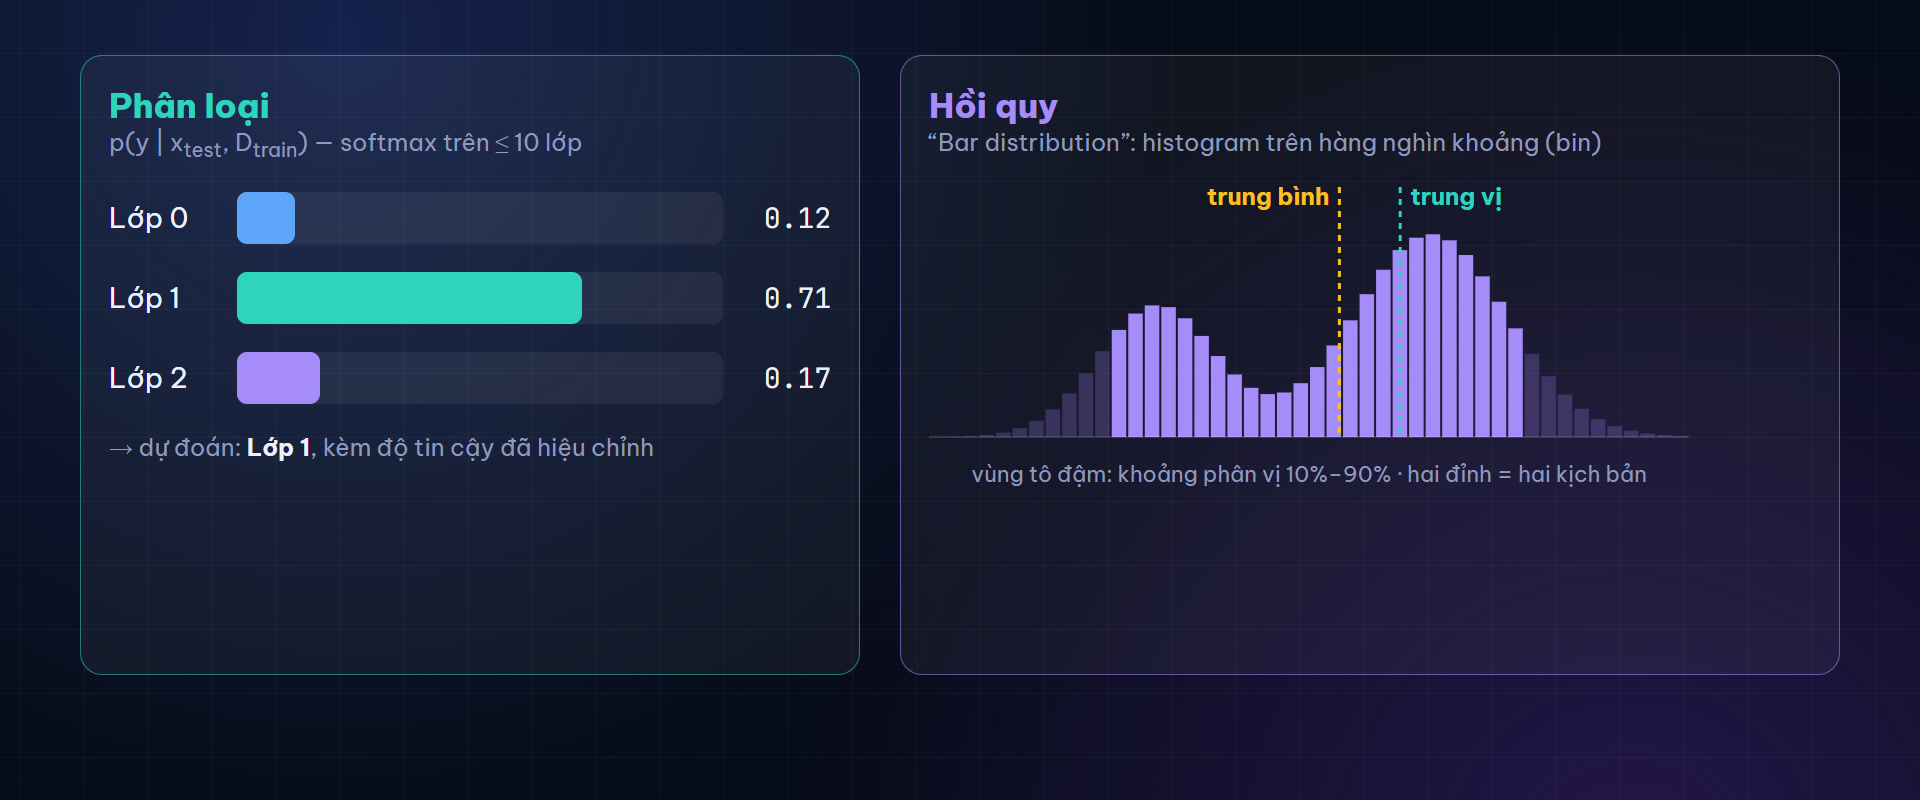
Hình 7. Bên trái: phân phối xác suất trên các lớp. Bên phải: phân phối dự đoán cho hồi quy dưới dạng histogram, có hai đỉnh. Vùng tô đậm là khoảng phân vị 10% đến 90%. Hình minh họa, không phải kết quả từ bài báo.
Bài báo minh họa khả năng này bằng thí nghiệm khe Young (double-slit): mô hình quan sát vị trí của 1.000 photon trên màn và dự đoán phân phối cường độ sáng theo độ rộng khe và khoảng cách khe. Phân phối thật có nhiều vân sáng tối xen kẽ, và TabPFN tái tạo được cấu trúc này.
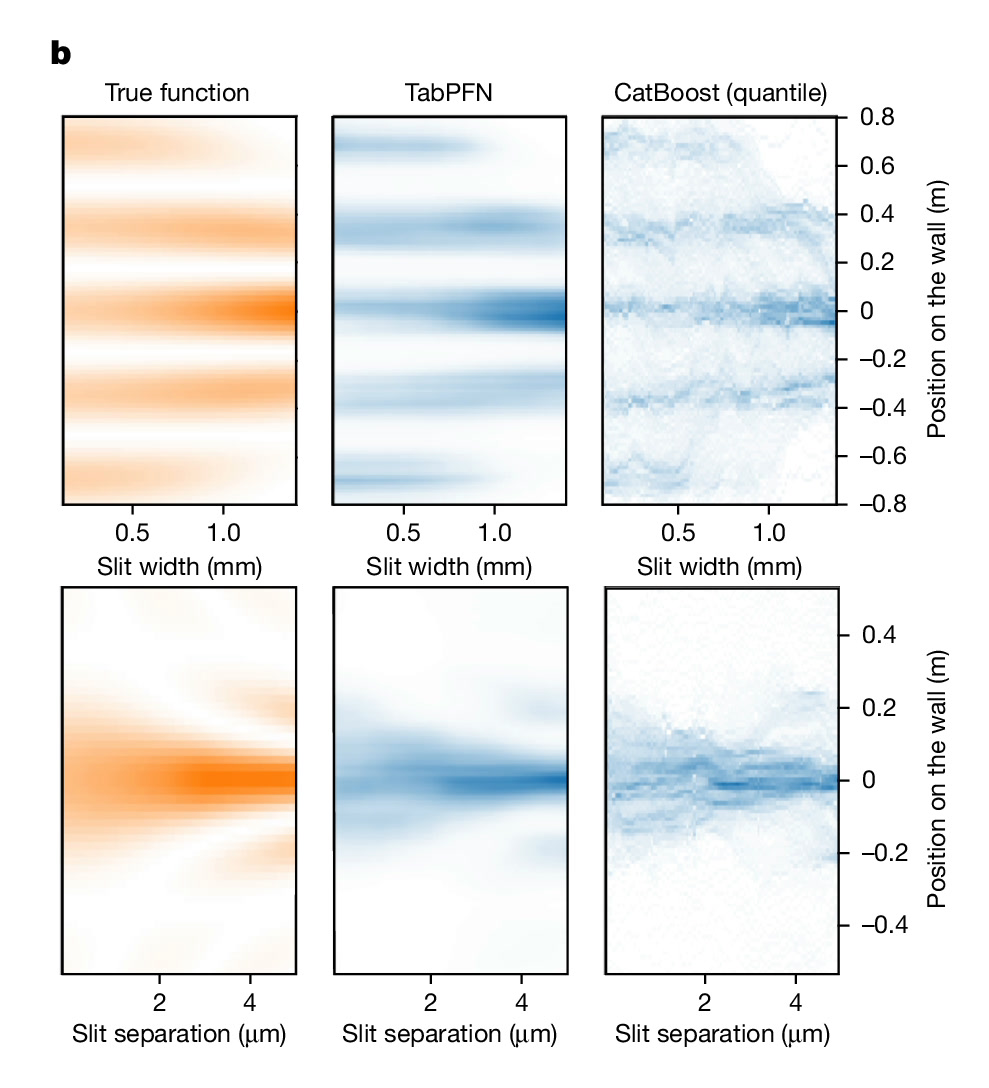
Hình 8. Dự đoán phân phối cường độ sáng trong thí nghiệm khe Young sau khi quan sát 1.000 photon. Cột trái: hàm thật. Cột giữa: TabPFN. Cột phải: CatBoost với hồi quy phân vị. Nguồn: Hollmann et al., Nature 637 (2025), Fig. 3b, CC BY 4.0.
4.4. Giao diện lập trình
TabPFN được phát hành dưới dạng thư viện Python với giao diện giống scikit-learn:
from tabpfn import TabPFNClassifier, TabPFNRegressor

clf = TabPFNClassifier()
clf.fit(X_train, y_train)            # lưu ngữ cảnh, không chạy vòng tối ưu
proba = clf.predict_proba(X_test)    # một lượt forward

reg = TabPFNRegressor()
reg.fit(X_train, y_train)
q = reg.predict(X_test, output_type="quantiles", quantiles=[0.1, 0.5, 0.9])
Vì giao diện giống scikit-learn, TabPFN có thể thay vào các pipeline có sẵn, dùng với cross_val_score, Pipeline hoặc các công cụ giải thích như SHAP. GPU được khuyến nghị; trên CPU mô hình vẫn chạy nhưng chậm hơn đáng kể với bảng lớn.
5. Prior: dữ liệu huấn luyện hoàn toàn tổng hợp
TabPFN không được huấn luyện trên bất kỳ bộ dữ liệu thật nào. Toàn bộ dữ liệu huấn luyện được sinh ra từ một prior dựa trên mô hình nhân quả cấu trúc (Structural Causal Model, SCM). Lý do chọn SCM là nhiều bảng trong thực tế phản ánh quan hệ nhân quả: tuổi và thói quen hút thuốc ảnh hưởng đến huyết áp, huyết áp ảnh hưởng đến nguy cơ bệnh tim. Một prior sinh dữ liệu theo đồ thị nhân quả sẽ tạo ra các bảng có cấu trúc tương tự.
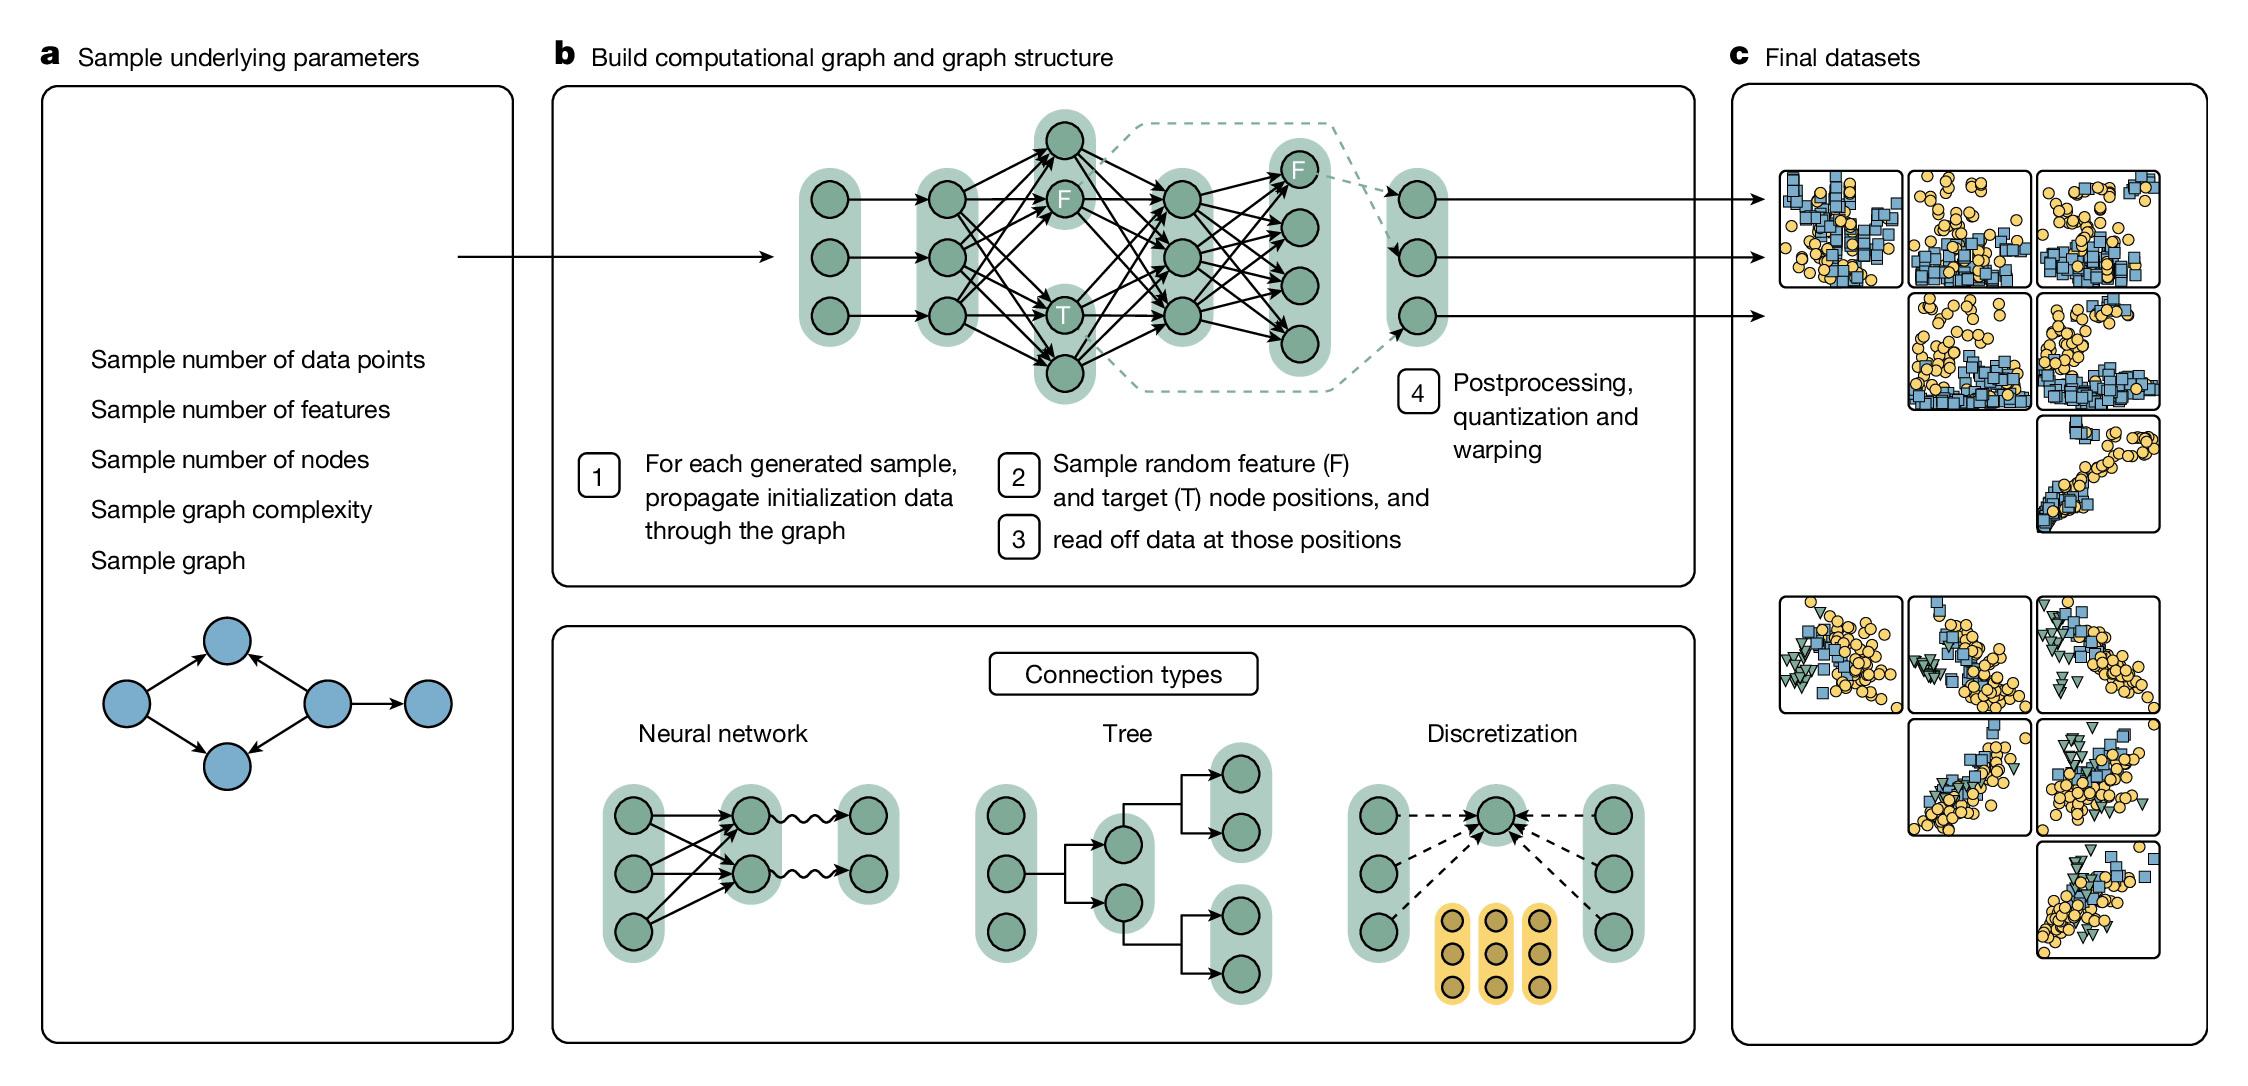
Hình 9. Quy trình sinh một bộ dữ liệu tổng hợp. (a) Lấy mẫu siêu tham số: số điểm dữ liệu, số đặc trưng, số nút, độ phức tạp đồ thị. (b) Dựng đồ thị tính toán, lan truyền dữ liệu, chọn vị trí nút đặc trưng (F) và nút mục tiêu (T), sau đó hậu xử lý. Phía dưới là ba kiểu kết nối: mạng nơ-ron, cây, rời rạc hóa. (c) Một số bộ dữ liệu được sinh ra. Nguồn: Hollmann et al., Nature 637 (2025), Fig. 2, CC BY 4.0.
Quy trình sinh một bộ dữ liệu gồm các bước sau.
Bước 1: Lấy mẫu siêu tham số của bộ dữ liệu. Số mẫu, số đặc trưng, số nút trong đồ thị và độ khó được lấy ngẫu nhiên. Trong huấn luyện TabPFN v2, số mẫu huấn luyện của mỗi bộ được lấy đều đến 2.048, phần giữ lại để tính mất mát cố định 128 mẫu, số đặc trưng lấy theo phân phối Beta rồi co giãn về khoảng 1 đến 160, và tổng số ô của mỗi bảng không vượt quá 75.000.
Bước 2: Dựng đồ thị có hướng không chu trình (DAG). Đồ thị được sinh bằng thuật toán growing network with redirection, một quá trình gắn kết ưu tiên (preferential attachment) tạo ra đồ thị có một số nút có nhiều kết nối. Số nút được lấy theo phân phối log-đều. Đồ thị có thể là một thành phần liên thông hoặc gồm nhiều đồ thị con rời nhau.
Bước 3: Khởi tạo nút gốc. Các nút không có cạnh vào nhận giá trị nhiễu từ phân phối chuẩn, phân phối đều hoặc hỗn hợp của chúng. Trong một số bộ dữ liệu, các mẫu được trộn với một số "nguyên mẫu" (prototype) để tạo ra sự phụ thuộc giữa các hàng.
Bước 4: Lan truyền qua các cạnh. Mỗi cạnh áp dụng một trong ba loại hàm:
- Một mạng nơ-ron nhỏ với hàm kích hoạt chọn ngẫu nhiên từ danh sách gồm identity, log, sigmoid, giá trị tuyệt đối, sin, tanh, rank, bình phương, lũy thừa, smooth ReLU, hàm bậc thang và modulo.
- Một cây quyết định ngẫu nhiên.
- Rời rạc hóa: gán giá trị về nguyên mẫu gần nhất trong nguyên mẫu ngẫu nhiên, tạo ra biến danh mục.
Nhiễu Gauss được cộng vào ở mỗi cạnh.
Bước 5: Chọn nút đặc trưng và nút mục tiêu. Một số nút được chọn ngẫu nhiên làm đặc trưng, một nút làm mục tiêu. Với hồi quy, mục tiêu là một nút liên tục. Với phân loại, mục tiêu là một nút danh mục có tối đa 10 lớp. Vì các nút được chọn ngẫu nhiên trong đồ thị, đặc trưng có thể là nguyên nhân, hệ quả, hoặc không liên quan đến mục tiêu.
Bước 6: Hậu xử lý. Để dữ liệu giống dữ liệu thật hơn, một số phép biến đổi được áp dụng ngẫu nhiên: bẻ cong phân phối của đặc trưng bằng hàm Kumaraswamy, lượng tử hóa thành các mức rời rạc, và xóa ngẫu nhiên một tỉ lệ ô để tạo giá trị thiếu dạng MCAR (missing completely at random).
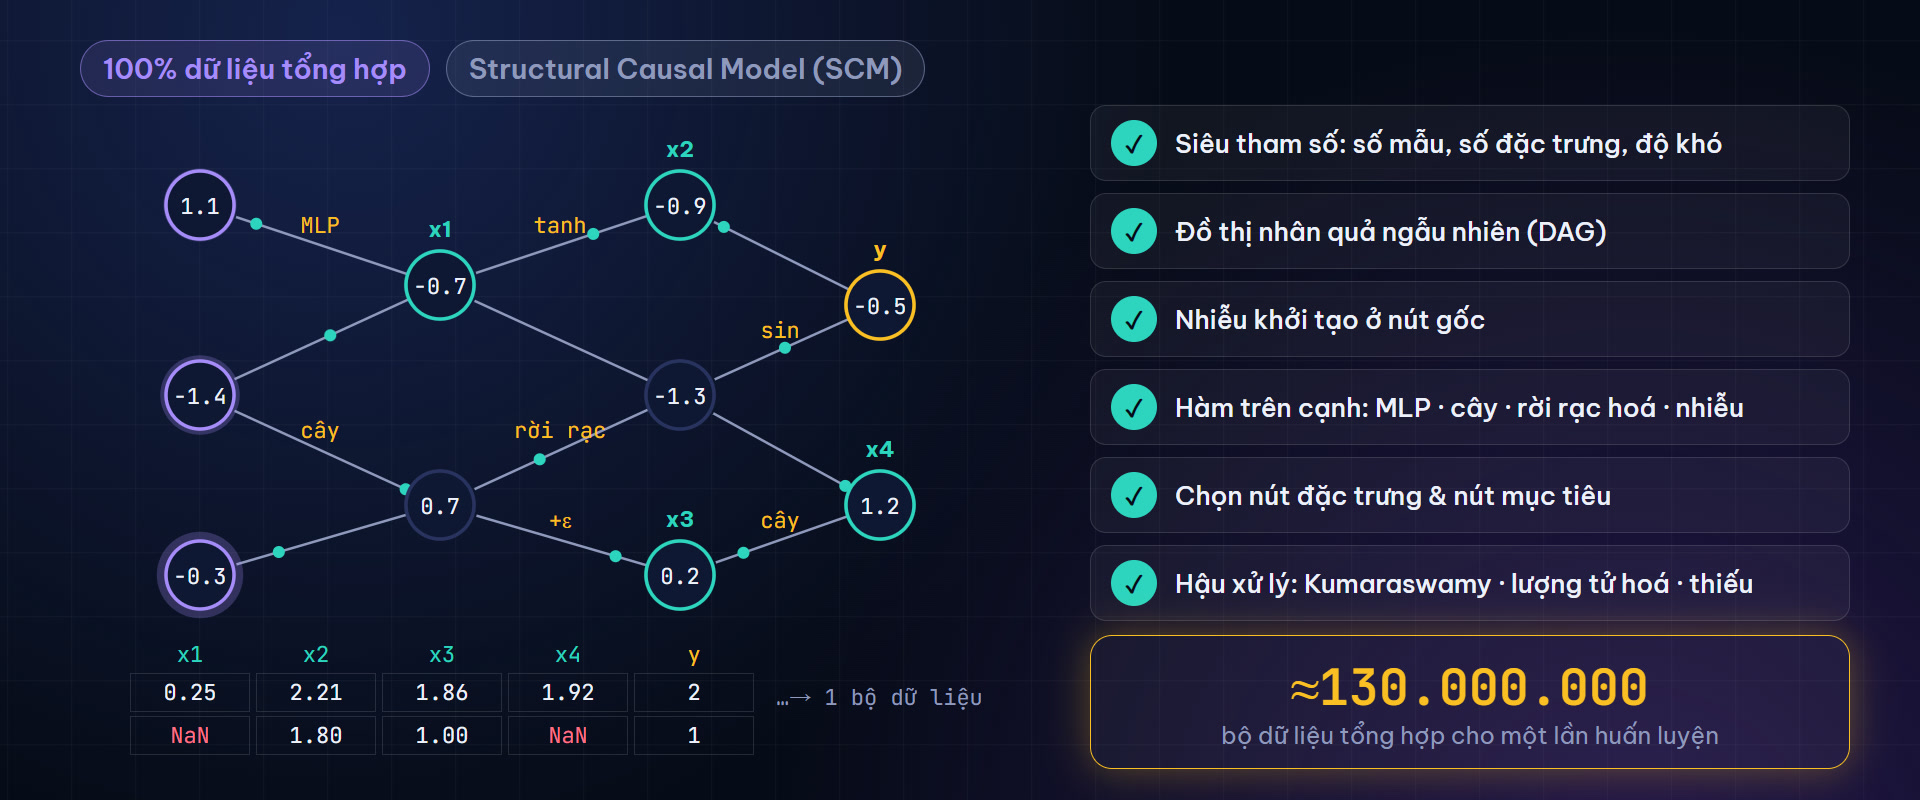
Hình 10. Minh họa một đồ thị nhân quả với các hàm khác nhau trên từng cạnh (MLP, cây, tanh, sin, rời rạc hóa, cộng nhiễu). Các nút được chọn làm đặc trưng (x1 đến x4) và mục tiêu (y), sau đó hậu xử lý để tạo ra bảng có giá trị thiếu.
Lặp lại quy trình này khoảng 130 triệu lần cho ra tập huấn luyện của TabPFN v2. Mỗi bộ dữ liệu có cấu trúc, số chiều, mức nhiễu và kiểu quan hệ khác nhau. Mạng phải học cách dự đoán tốt trên toàn bộ phân phối này, nghĩa là nó phải tự nhận ra từ tập huấn luyện bộ dữ liệu đang xét thuộc loại nào: quan hệ gần tuyến tính hay phi tuyến mạnh, đặc trưng nào có thông tin, mức nhiễu cao hay thấp.
Prior cũng là nơi chứa giả định quy nạp (inductive bias) của TabPFN. Ở mô hình cây, giả định quy nạp nằm trong cấu trúc thuật toán, ví dụ chia không gian theo trục tọa độ. Ở TabPFN, nó nằm trong dữ liệu huấn luyện. Thay đổi prior là thay đổi thuật toán mà mạng học được.
6. Kiến trúc
6.1. Mỗi ô là một token
Trong mô hình ngôn ngữ, mỗi từ (hoặc một phần của từ) là một token. Trong TabPFN, mỗi ô của bảng là một token. Một bảng có hàng và cột cho ra token, kể cả cột nhãn.
Mỗi giá trị được mã hóa như sau:
- Chuẩn hóa z-score theo cột, dùng trung bình và độ lệch chuẩn tính trên tập huấn luyện.
- Thêm một cờ nhị phân cho biết ô đó có bị thiếu hay không. Giá trị thiếu được thay bằng 0.
- Chiếu qua một lớp tuyến tính để có vector nhúng (embedding).
Mạng không đọc tên cột, nên nếu hai cột có phân phối giống hệt nhau, nó không phân biệt được chúng. Để xử lý trường hợp này, TabPFN gắn cho mỗi cột một vector ngẫu nhiên có kích thước bằng 1/4 chiều nhúng, đưa qua một lớp tuyến tính đã học rồi cộng vào biểu diễn của các ô trong cột. Vector này không chứa thông tin về nội dung cột, chỉ dùng để định danh.
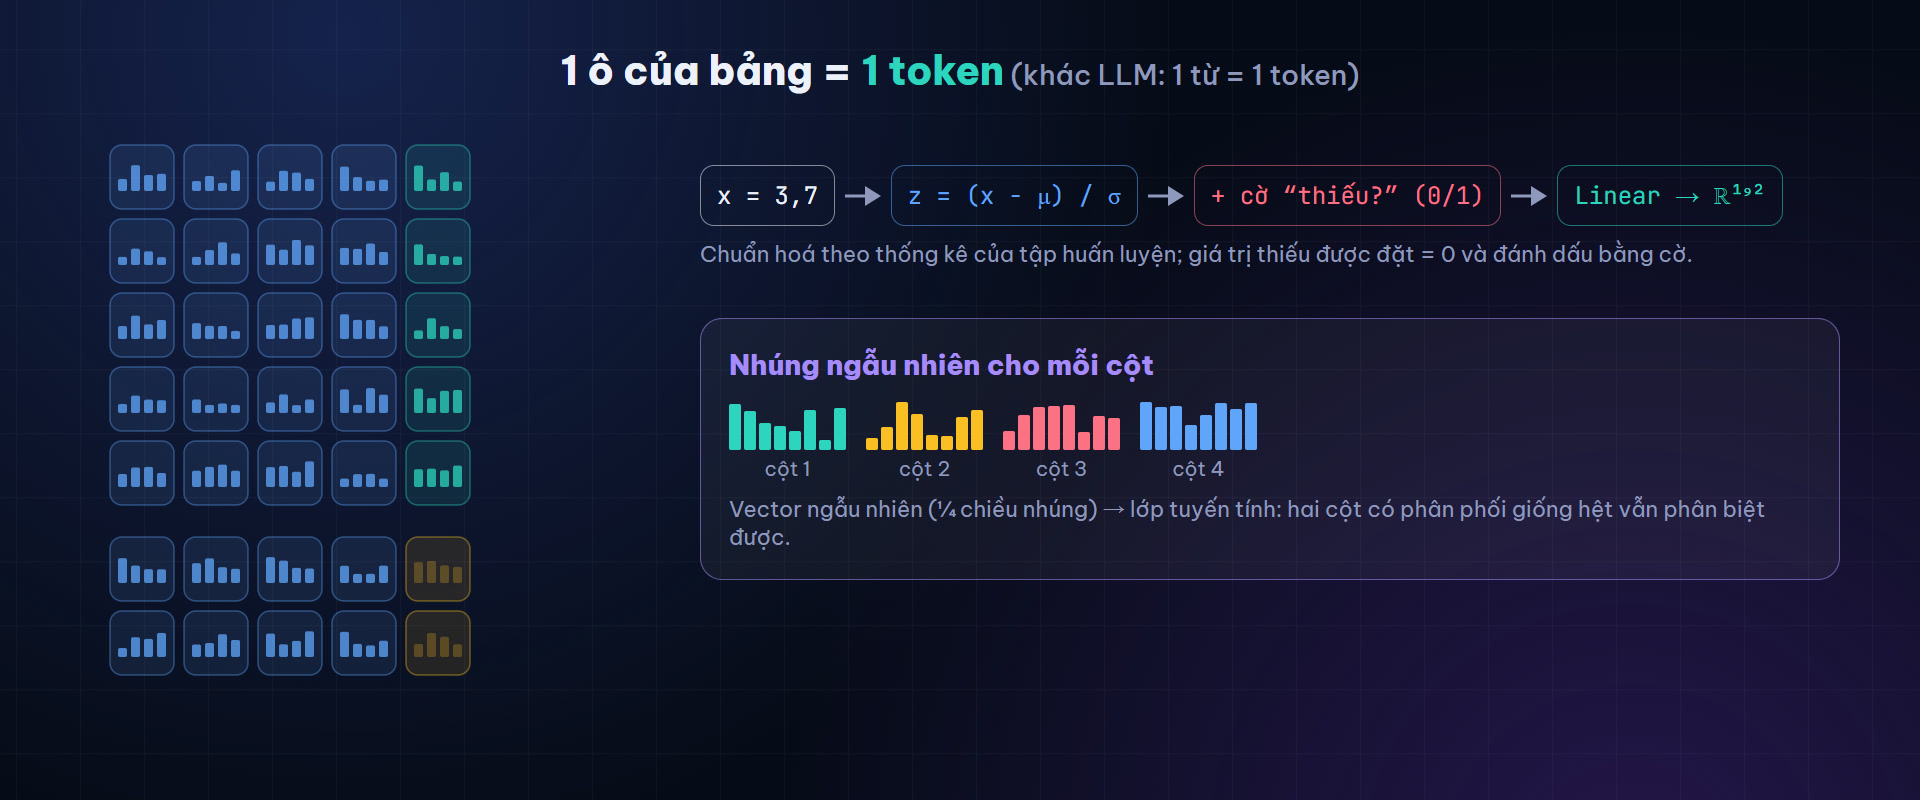
Hình 11. Mỗi ô của bảng trở thành một token: giá trị được chuẩn hóa, thêm cờ giá trị thiếu, chiếu thành vector nhúng, và cộng thêm vector định danh ngẫu nhiên của cột.
Trong cấu hình mặc định của phiên bản 2, mỗi vị trí token thực tế mã hóa hai đặc trưng liền nhau thay vì một, để giảm chi phí tính toán. Chi tiết này không thay đổi ý tưởng chung.
6.2. Attention hai chiều
Dữ liệu bảng có hai trục: hàng và cột. Một Transformer chuẩn xử lý chuỗi một chiều. TabPFN điều chỉnh kiến trúc encoder của Transformer để mỗi lớp có hai bước attention:
- Attention theo hàng (feature attention): các ô trong cùng một hàng trao đổi thông tin với nhau. Bước này cho phép mạng mô hình hóa quan hệ giữa các đặc trưng của cùng một mẫu.
- Attention theo cột (sample attention): mỗi ô trao đổi thông tin với các ô cùng cột ở các hàng khác. Bước này cho phép mạng so sánh một mẫu với các mẫu khác, tương tự cách k-NN hoặc kernel method so sánh điểm mới với các điểm huấn luyện.
Sau hai bước attention là một khối MLP xử lý từng ô độc lập. Mỗi khối con có kết nối tắt (residual connection) và chuẩn hóa lớp (layer normalization). TabPFN v2 có 12 lớp như vậy.
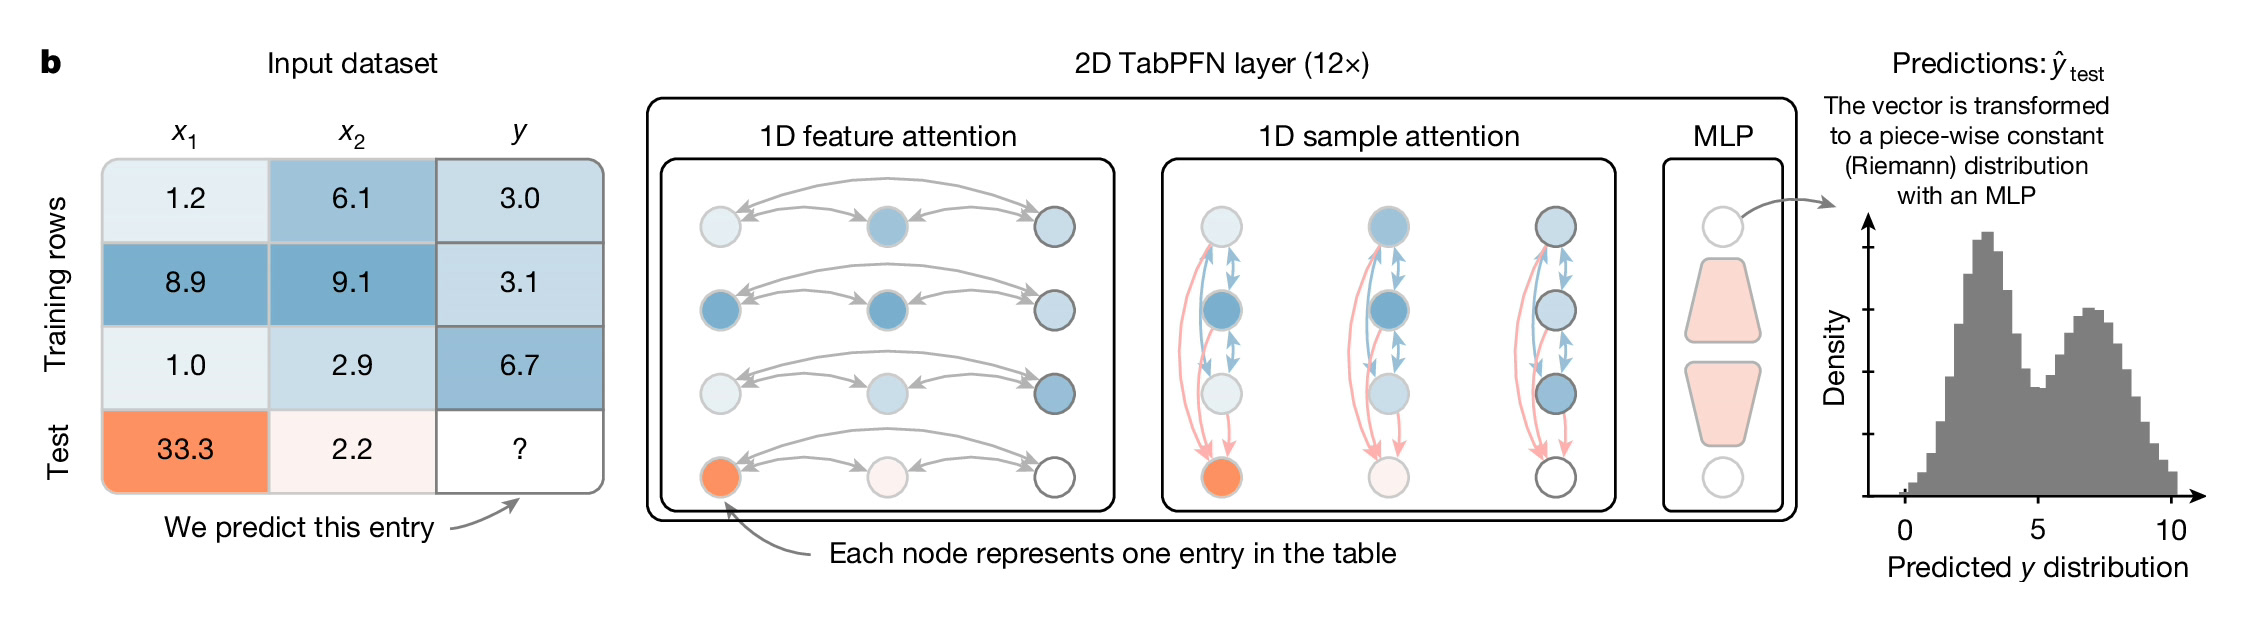
Hình 12. Kiến trúc TabPFN. Mỗi nút biểu diễn một ô trong bảng. Mỗi lớp gồm attention theo đặc trưng (1D feature attention), attention theo mẫu (1D sample attention) và MLP, lặp lại 12 lần. Biểu diễn của ô cần dự đoán được biến đổi thành phân phối dạng bậc thang (Riemann distribution). Nguồn: Hollmann et al., Nature 637 (2025), Fig. 1b, CC BY 4.0.
6.3. Mặt nạ attention: hàng kiểm thử chỉ nhìn hàng huấn luyện
Trong attention theo cột, có một ràng buộc quan trọng: hàng kiểm thử chỉ được attend đến các hàng huấn luyện, không attend đến nhau. Các hàng huấn luyện attend lẫn nhau như bình thường.
Nhờ ràng buộc này, dự đoán cho mỗi hàng kiểm thử độc lập với các hàng kiểm thử khác: kết quả cho một bệnh nhân không đổi dù ta dự đoán cùng lúc với một hay một nghìn bệnh nhân khác. Biểu diễn của tập huấn luyện cũng không phụ thuộc vào tập kiểm thử, nên có thể tính một lần rồi lưu lại (KV cache) cho nhiều lần dự đoán.
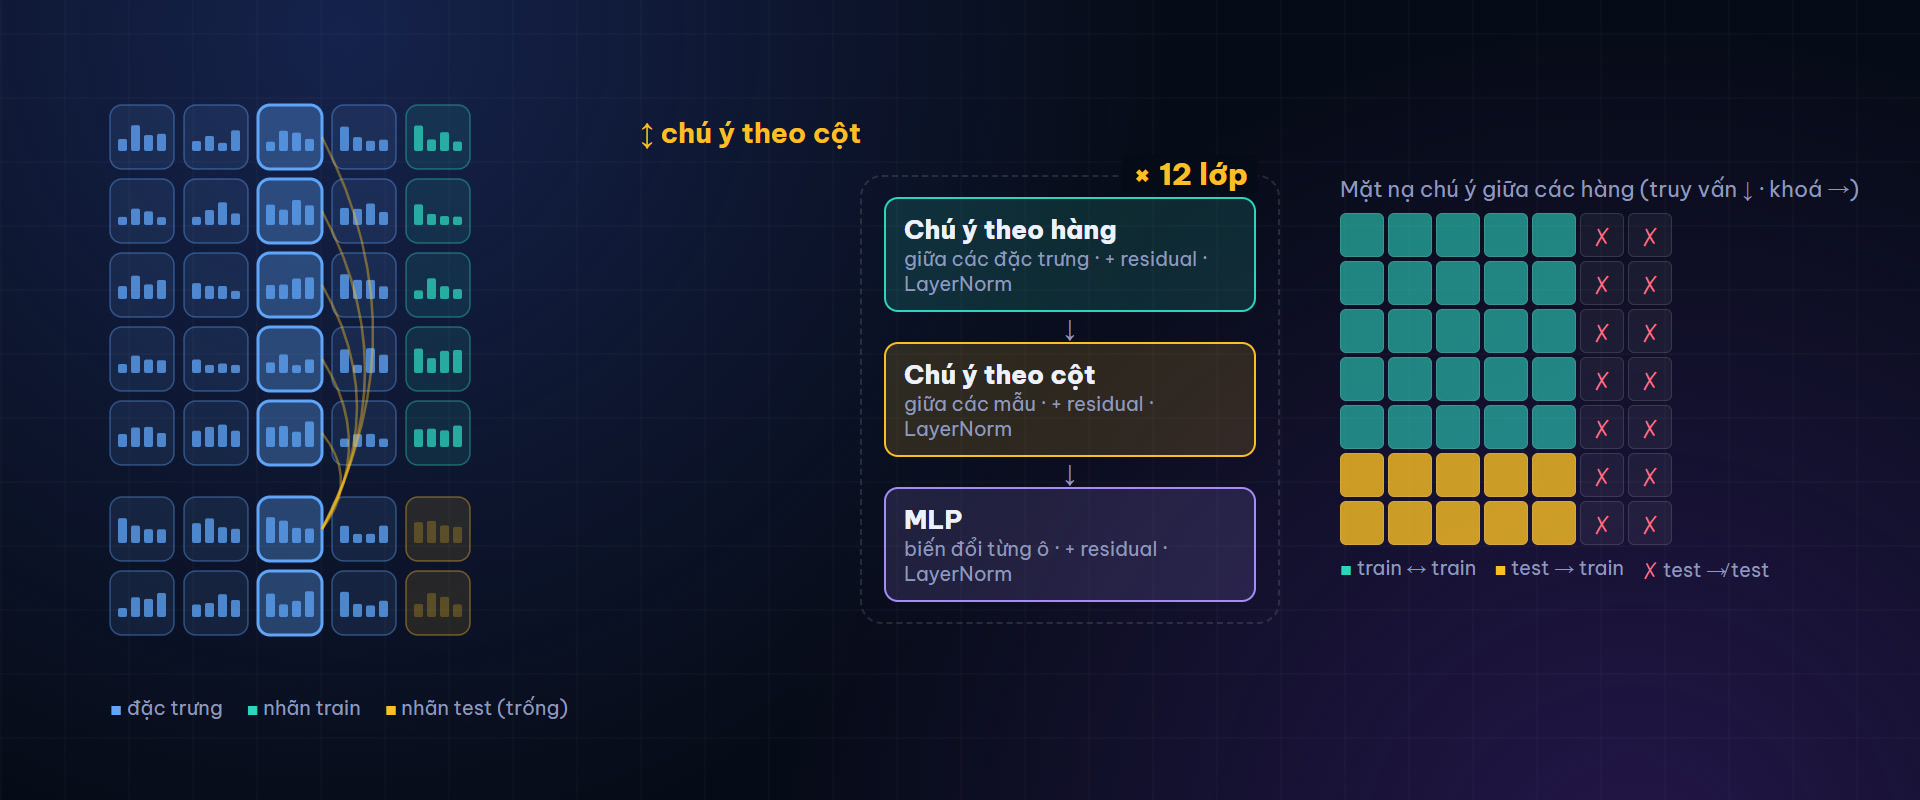
Hình 13. Trái: attention theo cột, một ô ở hàng kiểm thử nhìn sang các ô cùng cột ở hàng huấn luyện. Giữa: cấu trúc một lớp. Phải: mặt nạ attention giữa các hàng. Năm hàng đầu là hàng huấn luyện, hai hàng cuối là hàng kiểm thử. Ô đánh dấu ✗ là cặp không được phép attend.
6.4. Bất biến hoán vị
Attention là phép toán không phụ thuộc thứ tự đầu vào. TabPFN không dùng mã hóa vị trí (positional encoding) theo hàng hay theo cột, nên đầu ra không đổi khi hoán vị thứ tự các hàng huấn luyện. Với cột, vector định danh ngẫu nhiên phá vỡ tính đối xứng một phần, nhưng vì vector này được lấy ngẫu nhiên, mô hình không thể dựa vào thứ tự cột cụ thể. Đây là tính chất phù hợp với dữ liệu bảng, nơi thứ tự hàng và cột không mang ý nghĩa. Nhờ đó, cùng một mạng xử lý được bảng ở mọi kích thước trong giới hạn bộ nhớ.
6.5. Kích thước mô hình
TabPFN v2 có 12 lớp, chiều nhúng 192, 6 đầu attention mỗi lớp với chiều mỗi đầu là 32. Tổng số tham số khoảng 7,2 triệu, trong đó khoảng 7,08 triệu nằm ở 12 khối Transformer (số liệu từ các nghiên cứu phân tích nội bộ mô hình, ví dụ TabPFN Through The Looking Glass). Để so sánh, GPT-3 có 175 tỷ tham số, gấp khoảng 24.000 lần.
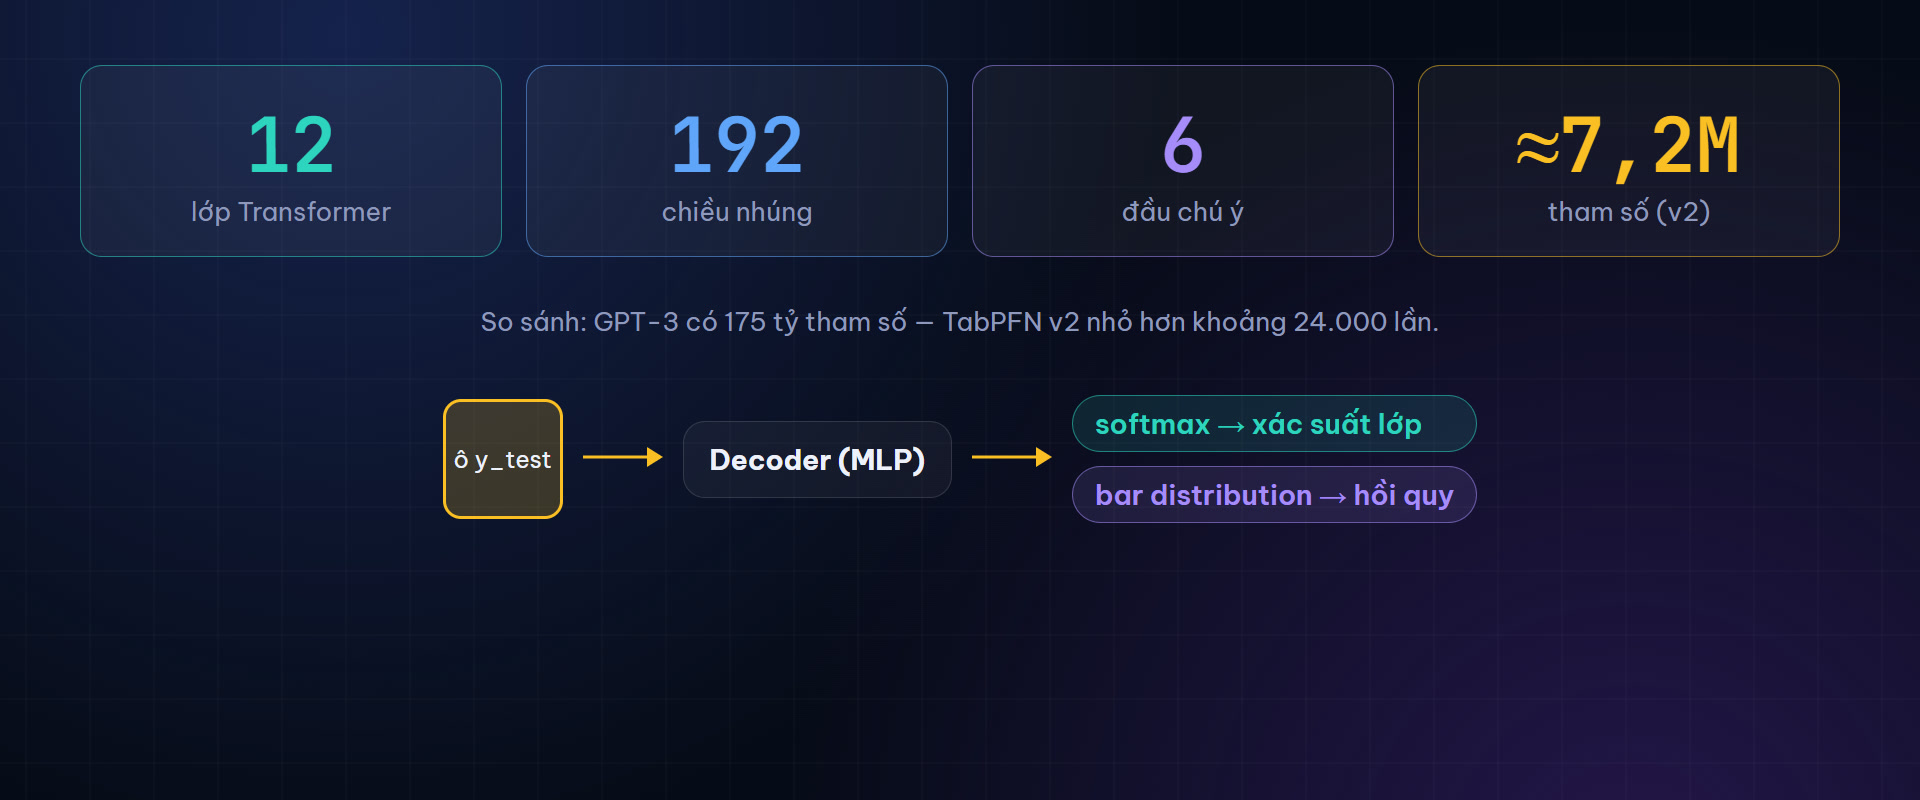
Hình 14. Thông số kiến trúc của TabPFN v2. Biểu diễn ở ô nhãn của hàng kiểm thử sau lớp cuối đi qua một MLP để tạo ra softmax (phân loại) hoặc bar distribution (hồi quy).
Mạng không cần lưu tri thức về thế giới như mô hình ngôn ngữ, nó chỉ cần biểu diễn một thuật toán dự đoán, nên vài triệu tham số là đủ. Phần lớn chi phí tính toán đến từ số token, tức số ô của bảng, chứ không phải từ số tham số.
6.6. Độ phức tạp tính toán
Attention theo cột có chi phí tỉ lệ với bình phương số hàng, attention theo hàng tỉ lệ với bình phương số cột. Bài báo ghi độ phức tạp tính toán là và bộ nhớ là , với là số mẫu và là số đặc trưng. Sau các tối ưu về bộ nhớ, mỗi ô cần dưới 1.000 byte, và một GPU H100 chứa được bảng khoảng 50 triệu ô, ví dụ 5 triệu hàng nhân 10 cột.
7. Huấn luyện trước
Quá trình huấn luyện trước chỉ diễn ra một lần. Ở mỗi bước:
- Sinh một lô (batch) gồm 64 bộ dữ liệu từ prior.
- Chia mỗi bộ thành phần ngữ cảnh (đóng vai trò tập huấn luyện) và phần giữ lại (đóng vai trò tập kiểm thử).
- Mạng dự đoán nhãn cho phần giữ lại, dựa trên phần ngữ cảnh.
- Tính cross-entropy giữa dự đoán và nhãn thật của phần giữ lại.
- Cập nhật trọng số bằng Adam, với tốc độ học tăng tuyến tính ở giai đoạn đầu (warmup) và giảm theo cosine.
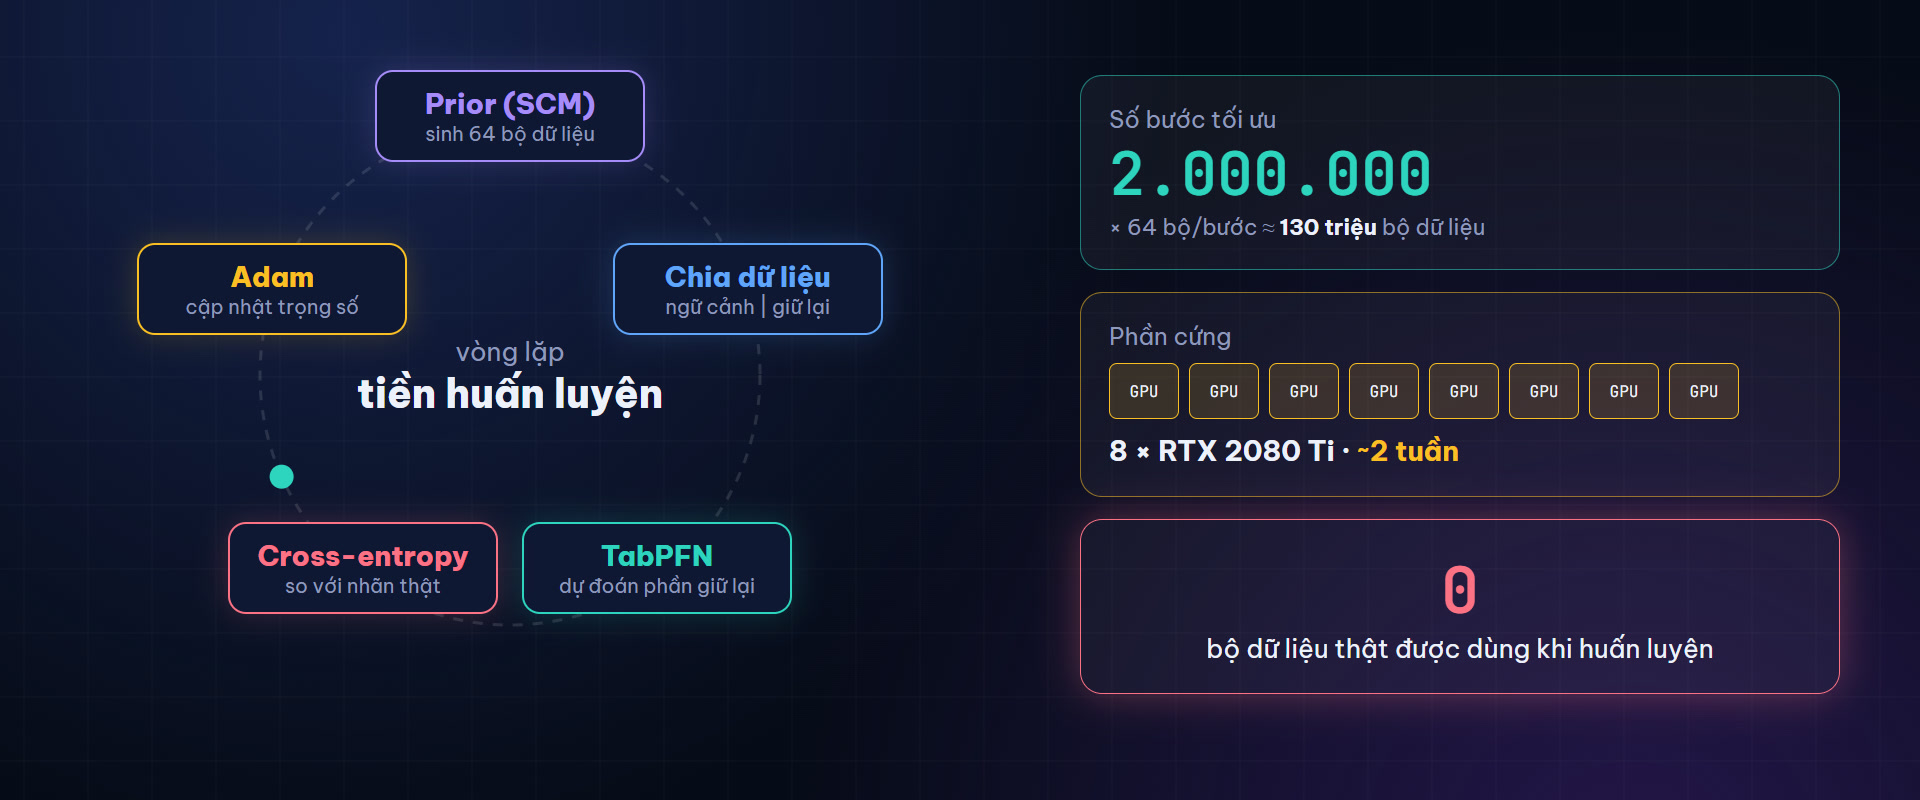
Hình 15. Vòng lặp huấn luyện trước: prior sinh dữ liệu, mạng dự đoán phần giữ lại, cross-entropy đo sai số, Adam cập nhật trọng số. Khoảng 2 triệu bước với 64 bộ dữ liệu mỗi bước.
TabPFN v2 được huấn luyện khoảng 2.000.000 bước, tương đương khoảng 130 triệu bộ dữ liệu. Chi phí là khoảng 2 tuần trên một máy có 8 GPU Nvidia RTX 2080 Ti. So với các mô hình nền tảng trong ngôn ngữ hoặc thị giác, đây là mức tài nguyên nhỏ; một nhóm nghiên cứu ở trường đại học có thể thực hiện được.
Trong suốt quá trình này, mạng không thấy một bộ dữ liệu thật nào. Mọi khả năng dự đoán trên dữ liệu thật đều là kết quả tổng quát hóa từ prior. Tập huấn luyện được sinh hoàn toàn bằng chương trình, nên khác với mô hình ngôn ngữ, TabPFN không có rủi ro rò rỉ dữ liệu benchmark vào tập huấn luyện (data contamination).
8. Suy luận trong thực tế
Một lượt forward đơn lẻ đã cho ra dự đoán, nhưng thư viện TabPFN mặc định chạy thêm một số bước để tăng độ ổn định.
8.1. Tổ hợp nhiều thành viên
TabPFN mặc định chạy một tổ hợp (ensemble) gồm 4 thành viên cho phân loại và 8 thành viên cho hồi quy. Các thành viên dùng cùng một mạng, chỉ khác nhau ở cách biến đổi dữ liệu đầu vào:
- Xáo trộn thứ tự cột: vì vector định danh cột là ngẫu nhiên, mỗi thứ tự cho ra dự đoán hơi khác.
- Hoán vị nhãn lớp: với phân loại, các lớp được đánh số lại theo thứ tự khác nhau.
- Tiền xử lý khác nhau: biến đổi phân vị (quantile transform), Yeo-Johnson, thêm đặc trưng SVD, mã hóa one-hot cho biến danh mục, loại bỏ giá trị ngoại lai cách trung bình quá 12 độ lệch chuẩn.
Dự đoán của các thành viên được lấy trung bình, sau đó hiệu chỉnh bằng nhiệt độ softmax. Thư viện cũng thêm một định danh ngẫu nhiên cho mỗi hàng để xử lý trường hợp có các hàng trùng nhau.
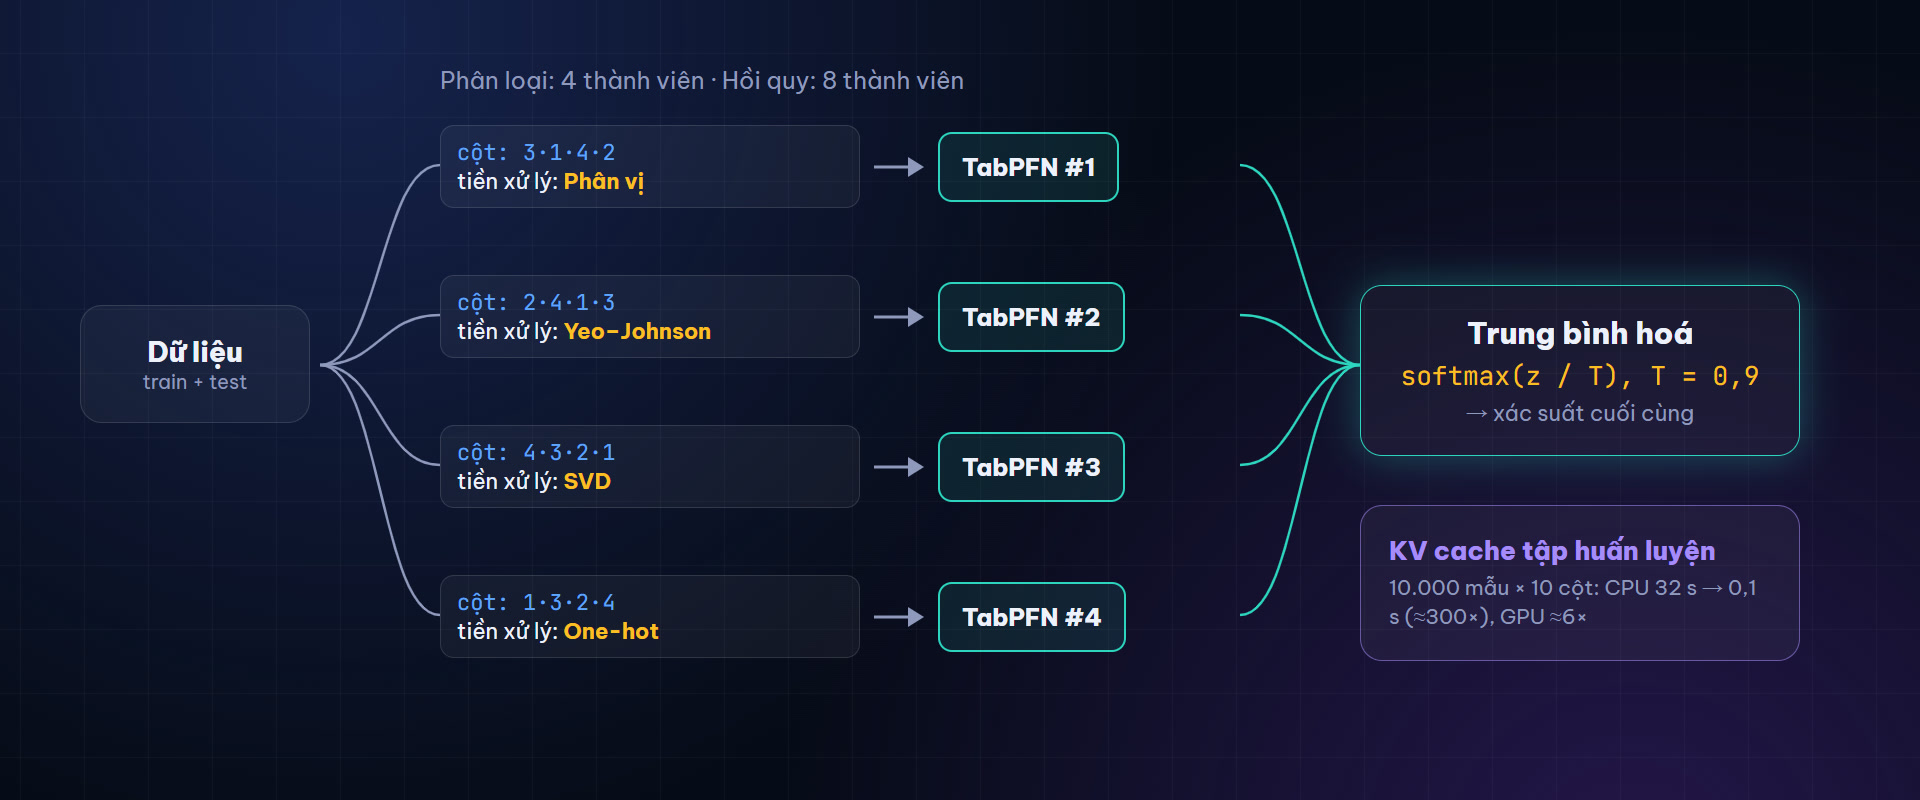
Hình 16. Khi suy luận, cùng một bảng được đưa qua mạng nhiều lần với thứ tự cột và cách tiền xử lý khác nhau. Kết quả được lấy trung bình rồi hiệu chỉnh bằng nhiệt độ T = 0,9.
8.2. Bộ nhớ đệm cho tập huấn luyện
Vì hàng kiểm thử không ảnh hưởng đến biểu diễn của hàng huấn luyện (mục 6.3), các khóa và giá trị attention (key, value) của tập huấn luyện có thể tính một lần rồi lưu lại. TabPFN dùng một biến thể multi-query attention để chỉ cần lưu một cặp key-value cho mỗi ô huấn luyện. Với 10.000 mẫu huấn luyện và 10 đặc trưng, bộ nhớ đệm giúp thời gian dự đoán trên CPU giảm từ 32 giây xuống 0,1 giây (khoảng 300 lần), và nhanh hơn khoảng 6 lần trên GPU. Với 100 đặc trưng, mức tăng tốc là khoảng 800 lần trên CPU và 30 lần trên GPU.
Bộ nhớ đệm hữu ích khi cần dự đoán nhiều lần trên cùng một tập huấn luyện, ví dụ khi phục vụ dự đoán qua API.
9. Kết quả đánh giá
9.1. Thiết lập trong bài báo Nature
Nhóm tác giả đánh giá trên hai bộ benchmark:
- Phân loại: 29 bộ dữ liệu từ AutoML Benchmark.
- Hồi quy: 28 bộ dữ liệu, gồm 16 bộ từ AutoML Benchmark và các bộ từ OpenML-CTR23.
Tất cả đều có tối đa 10.000 mẫu và 500 đặc trưng. Mỗi bộ dữ liệu được chạy 10 lần với các seed khác nhau, chia 90% huấn luyện và 10% kiểm thử. Các baseline gồm CatBoost, XGBoost, LightGBM, Random Forest, MLP, SVM và mô hình tuyến tính. Baseline được tinh chỉnh bằng tìm kiếm ngẫu nhiên với cross-validation 5-fold, ngân sách từ 30 giây đến 4 giờ, chạy trên 8 lõi CPU. TabPFN dùng thêm một GPU RTX 2080 Ti.
Chỉ số đánh giá là ROC AUC và độ chính xác cho phân loại, RMSE âm và cho hồi quy. Điểm được chuẩn hóa theo từng bộ dữ liệu: phương pháp tốt nhất trên bộ đó được 1, phương pháp kém nhất được 0, sau đó lấy trung bình trên các bộ.
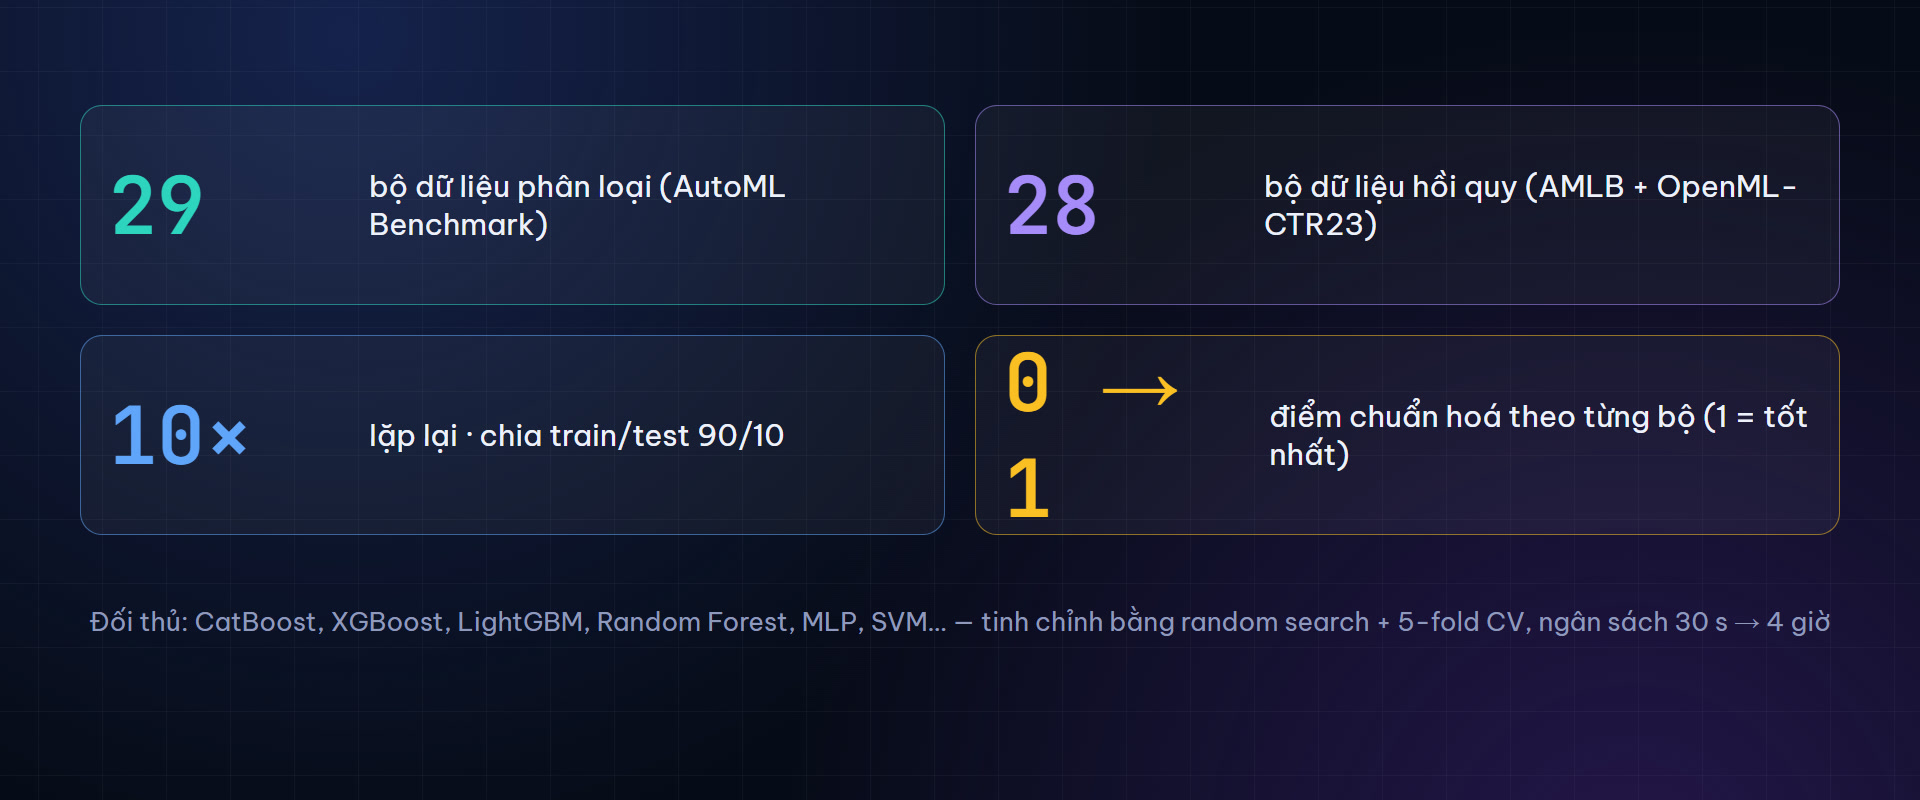
Hình 17. Thiết lập benchmark trong bài báo Nature.
Điểm chuẩn hóa phụ thuộc vào tập phương pháp được so sánh: nếu thêm hoặc bớt một phương pháp, điểm của các phương pháp khác có thể thay đổi. Điểm 0,939 ở phần sau là vị trí tương đối giữa phương pháp tốt nhất và kém nhất, lấy trung bình trên các bộ dữ liệu, khác với ROC AUC thô.
9.2. Kết quả chính
Với phân loại, ROC AUC chuẩn hóa của TabPFN ở cấu hình mặc định là 0,939, CatBoost mặc định là 0,752. Khi các baseline được tinh chỉnh 4 giờ, TabPFN (cũng được tinh chỉnh) đạt 0,952, CatBoost đạt 0,822.
Với hồi quy, RMSE âm chuẩn hóa của TabPFN mặc định là 0,923 so với 0,872 của CatBoost mặc định. Khi tinh chỉnh, các con số là 0,968 và 0,875.
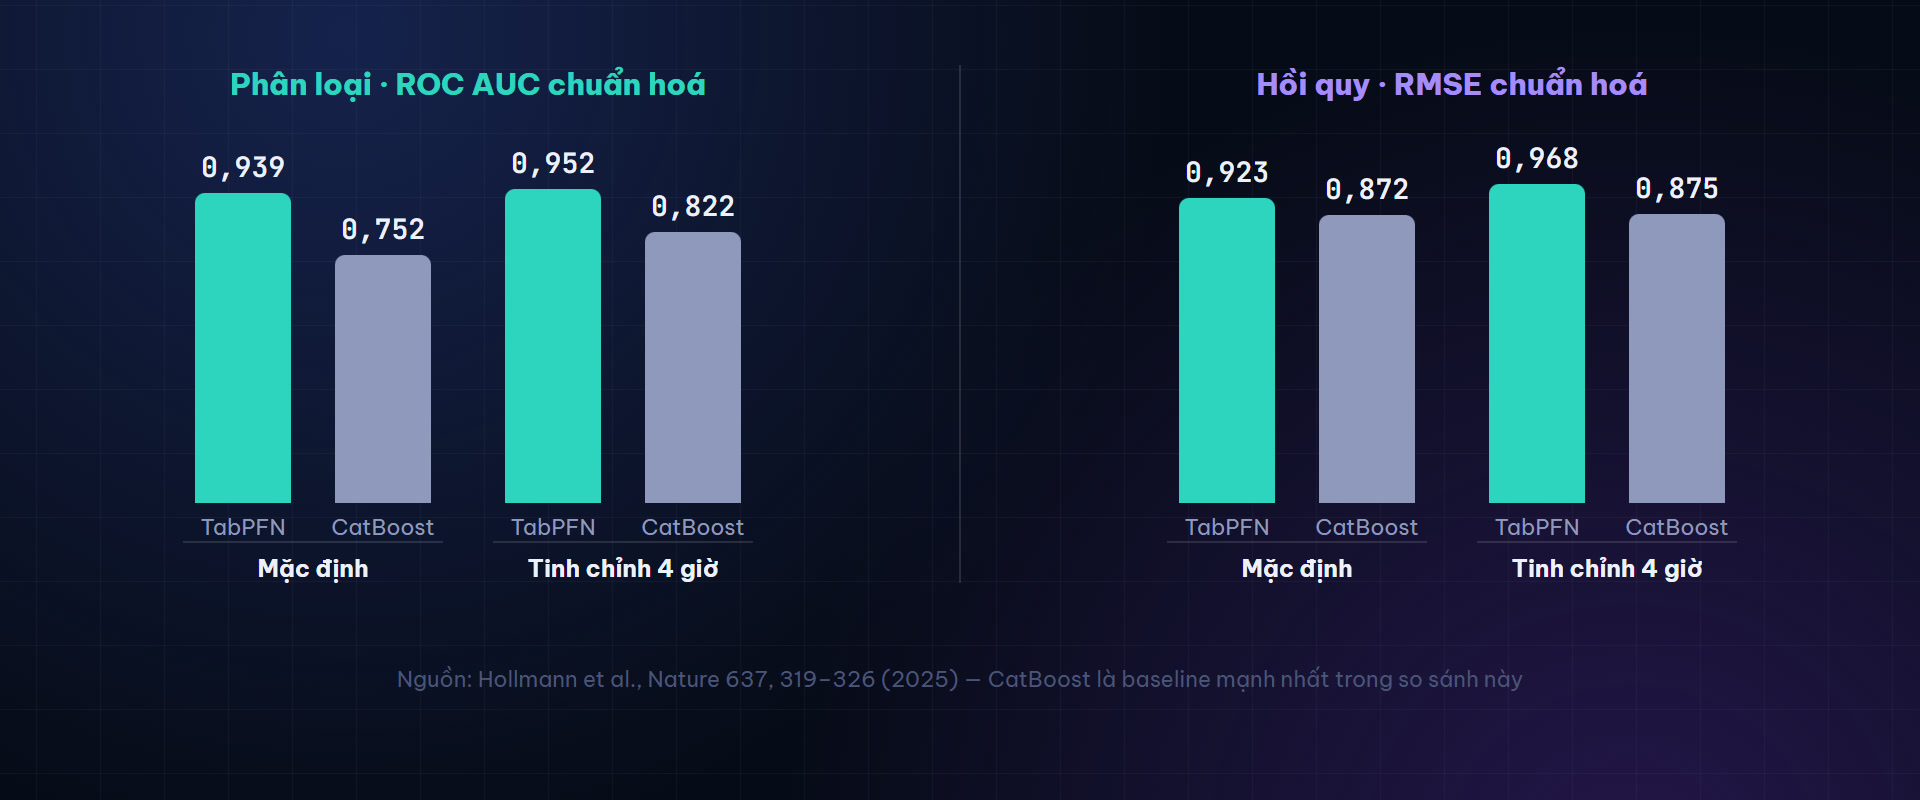
Hình 18. Điểm chuẩn hóa của TabPFN và CatBoost (baseline mạnh nhất trong so sánh) ở cấu hình mặc định và khi tinh chỉnh 4 giờ. Số liệu: Hollmann et al., Nature 637 (2025).
Hình gốc trong bài báo có thêm biểu đồ so sánh trên từng bộ dữ liệu giữa TabPFN và CatBoost, và điểm số theo thời gian chạy.
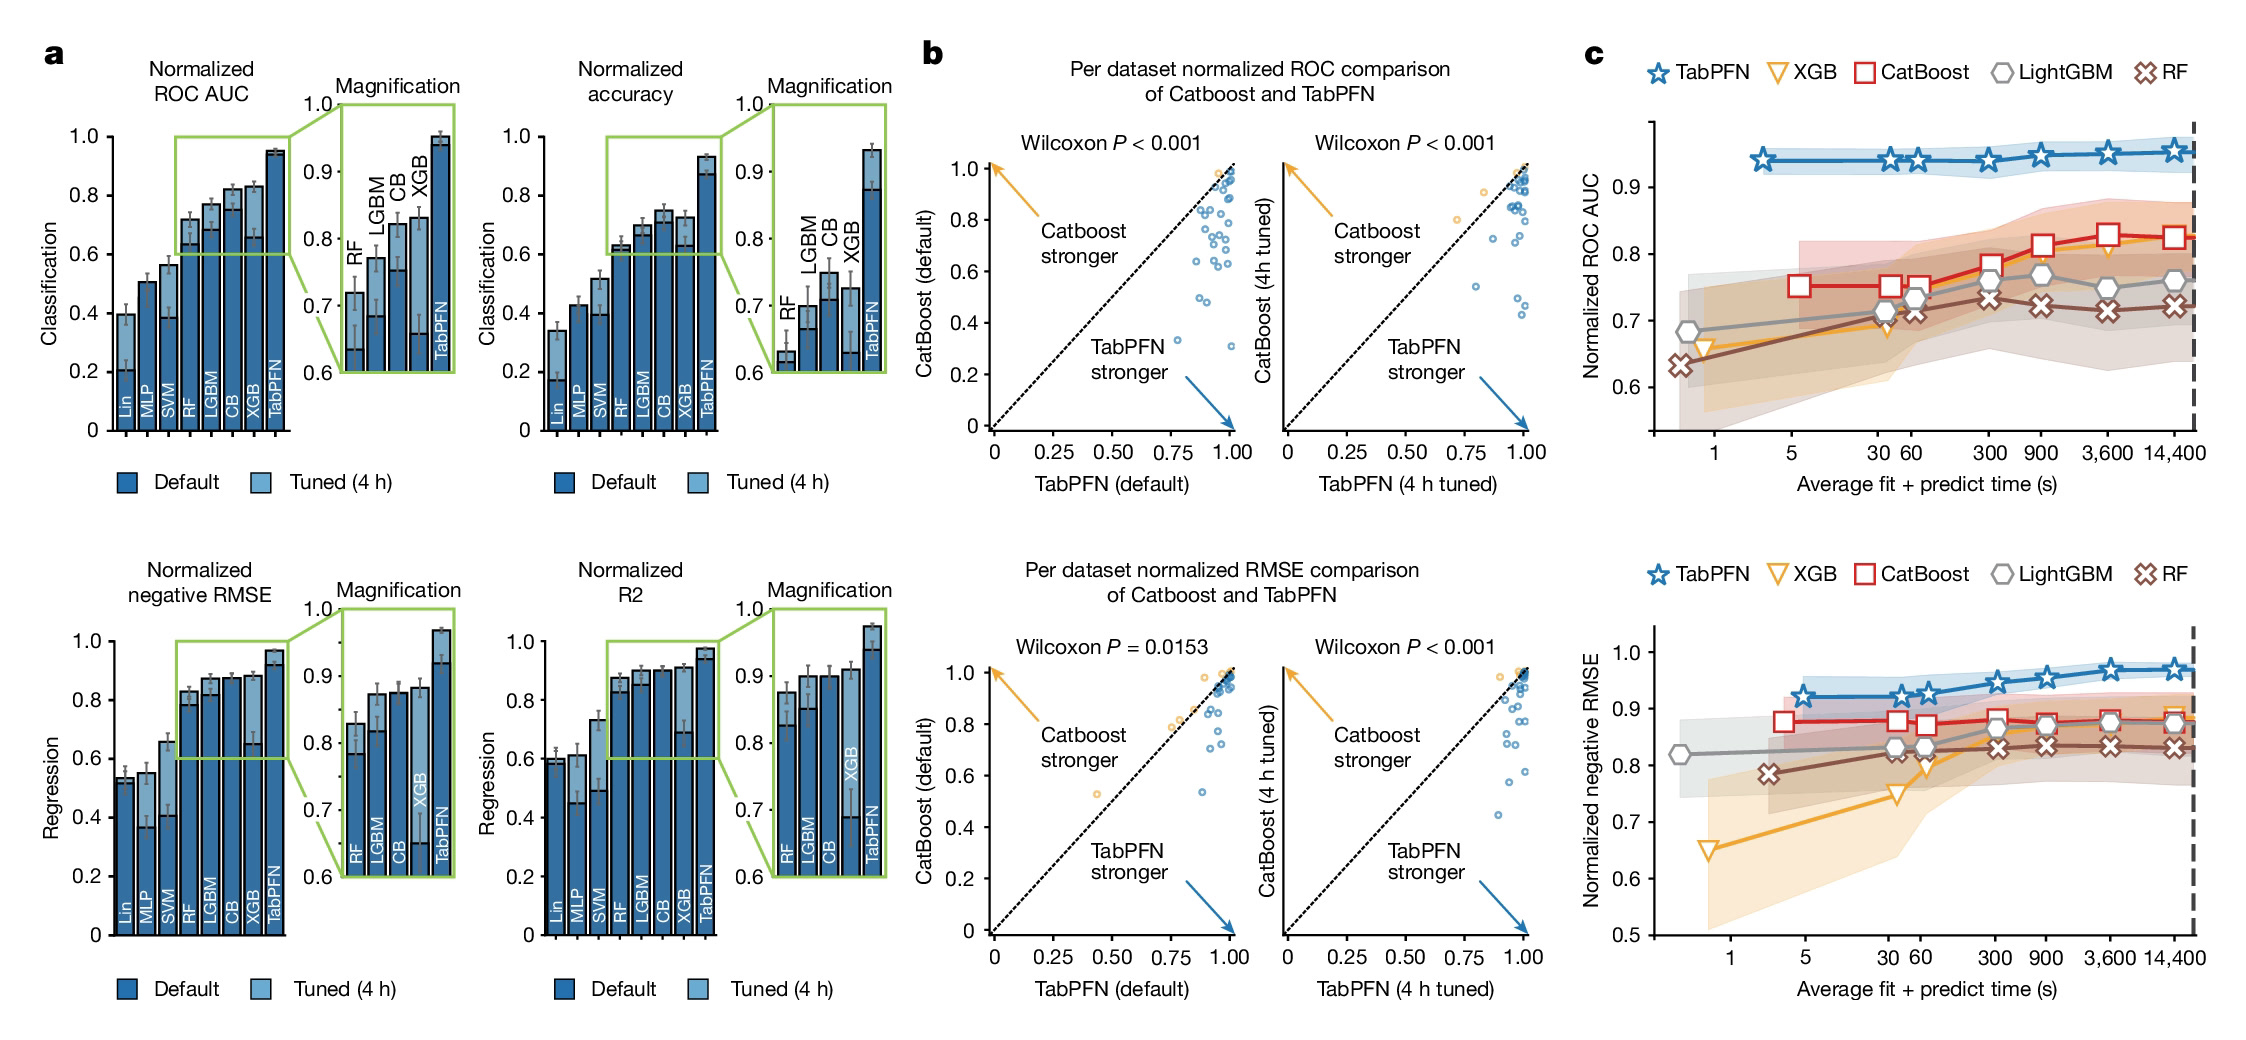
Hình 19. (a) Điểm trung bình của các phương pháp ở cấu hình mặc định và khi tinh chỉnh 4 giờ, cho phân loại (hàng trên) và hồi quy (hàng dưới). (b) So sánh từng bộ dữ liệu giữa TabPFN và CatBoost; điểm nằm dưới đường chéo là bộ dữ liệu TabPFN tốt hơn. (c) Điểm số theo tổng thời gian huấn luyện và dự đoán. Khoảng tin cậy 95%. Nguồn: Hollmann et al., Nature 637 (2025), Fig. 4, CC BY 4.0.
Ở biểu đồ (b), phần lớn các điểm nằm dưới đường chéo, nhưng vẫn có một số bộ dữ liệu CatBoost cho kết quả tốt hơn. Kết quả trung bình không đảm bảo TabPFN tốt hơn trên mọi bộ dữ liệu cụ thể.
9.3. Thời gian
Ở cấu hình mặc định, TabPFN mất trung bình 2,8 giây cho mỗi bộ dữ liệu phân loại và 4,8 giây cho hồi quy, tính cả huấn luyện và dự đoán. Kết quả này cao hơn kết quả của các baseline đã tinh chỉnh 4 giờ. Nếu tính theo thời gian, đó là mức chênh lệch 5.140 lần cho phân loại và khoảng 3.000 lần cho hồi quy.
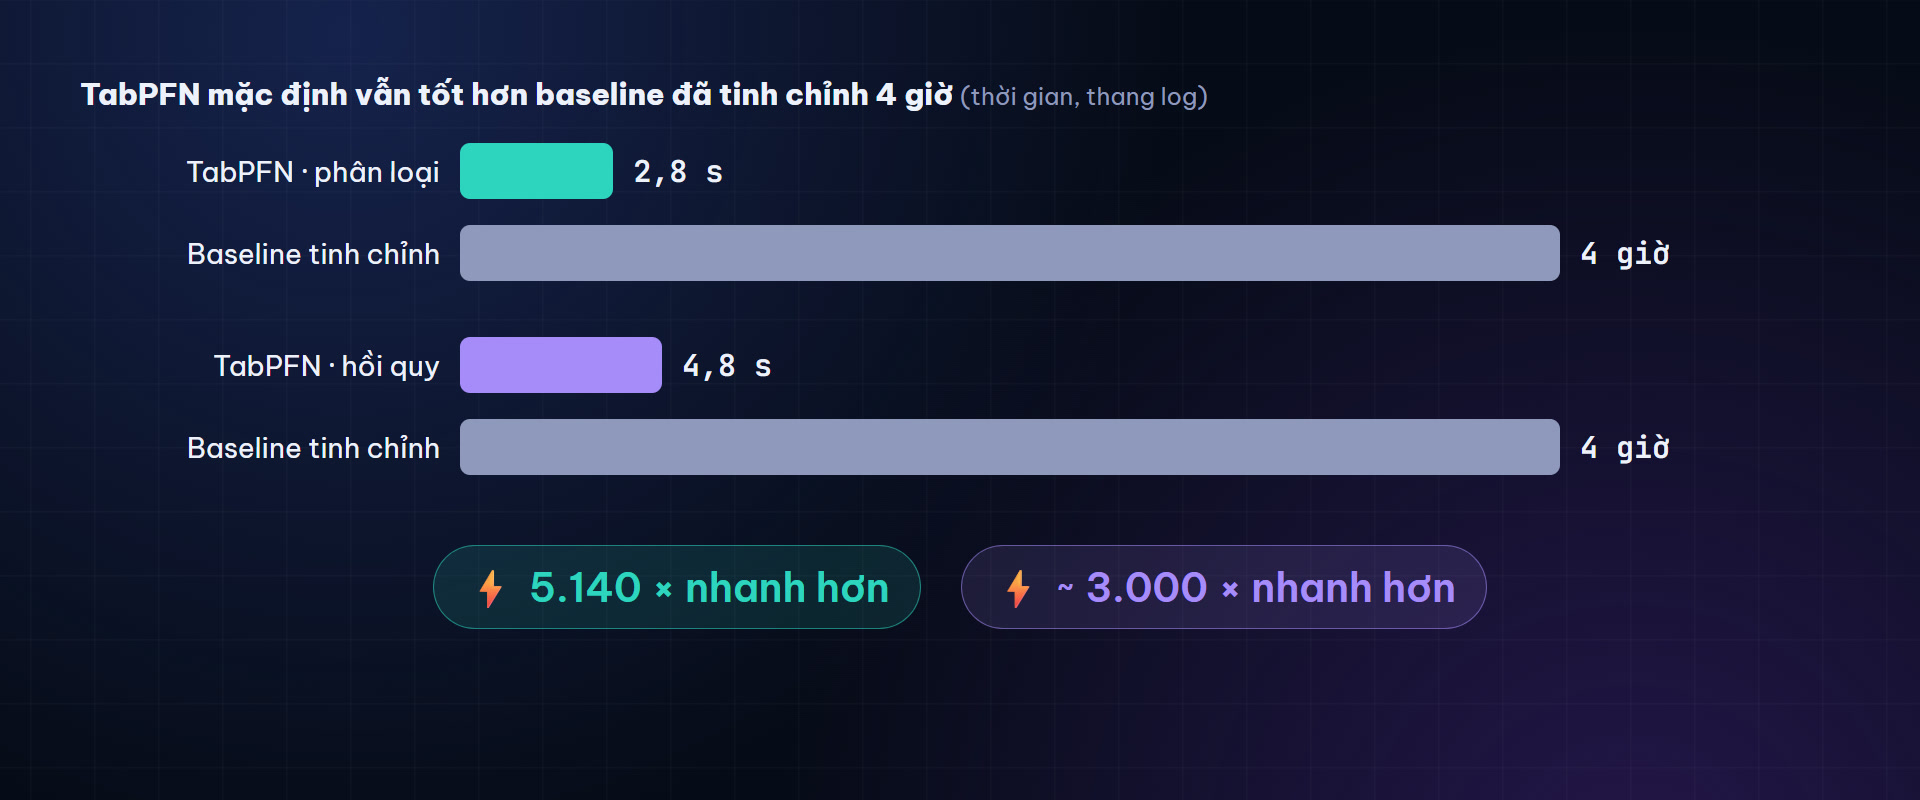
Hình 20. Thời gian của TabPFN ở cấu hình mặc định so với ngân sách 4 giờ của baseline (thang logarit).
Phép so sánh này không cùng phần cứng: TabPFN dùng GPU, baseline dùng CPU. Nhóm tác giả có chạy lại baseline với GPU và cho biết kết quả không thay đổi nhiều trên các bộ dữ liệu nhỏ này. Ngoài ra, 4 giờ là ngân sách tinh chỉnh tối đa; nếu baseline chỉ được tinh chỉnh vài phút, khoảng cách thời gian sẽ nhỏ hơn nhiều.
9.4. Độ bền vững
Nhóm tác giả thử thay đổi dữ liệu theo nhiều cách: thêm đặc trưng không có thông tin, thêm giá trị ngoại lai, bỏ bớt mẫu, bỏ bớt đặc trưng. Kết quả cho thấy TabPFN không suy giảm nhiều hơn các baseline. Đặc biệt, với 50% số mẫu huấn luyện, TabPFN đạt độ chính xác ngang CatBoost mặc định dùng toàn bộ mẫu. Với dữ liệu nhỏ, điều này có nghĩa là cùng một mức chất lượng cần ít dữ liệu hơn.
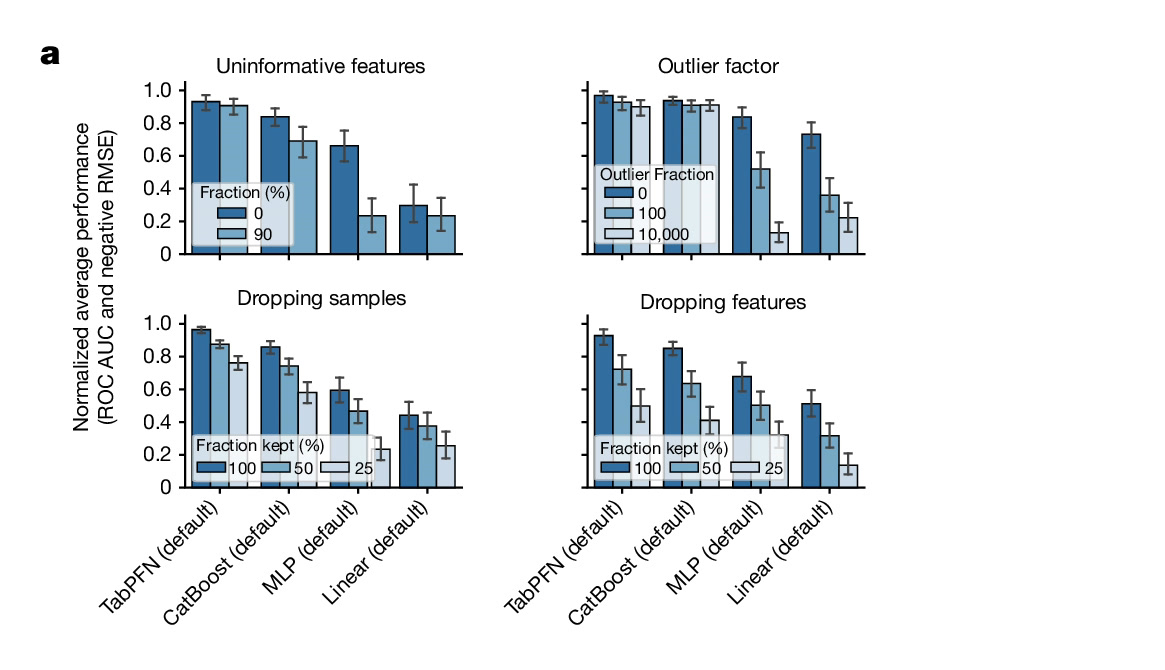
Hình 21. Hiệu năng khi thêm đặc trưng không có thông tin, thêm ngoại lai, bỏ bớt mẫu và bỏ bớt đặc trưng. Điểm được chuẩn hóa chung trong mỗi thí nghiệm. Nguồn: Hollmann et al., Nature 637 (2025), Fig. 5a, CC BY 4.0.
Bài báo cũng phân tích theo đặc điểm dữ liệu (có giá trị thiếu hay không, có biến danh mục hay không, số mẫu, số đặc trưng). Khác biệt giữa các nhóm nhìn chung nhỏ. Nhóm có ngoại lai ở biến mục tiêu cho thấy khác biệt rõ nhất, nhưng khoảng tin cậy vẫn chồng lấn.
9.5. Hành vi trên các hàm đơn giản
Trên các hàm một chiều như , , và hàm bậc thang, TabPFN cho ra đường dự đoán trơn khi hàm thật trơn, và có bậc khi hàm thật có bậc. CatBoost cho đường dự đoán dạng bậc thang trong mọi trường hợp, do cách mô hình cây chia không gian theo ngưỡng. MLP và mô hình tuyến tính không khớp được các hàm dao động.
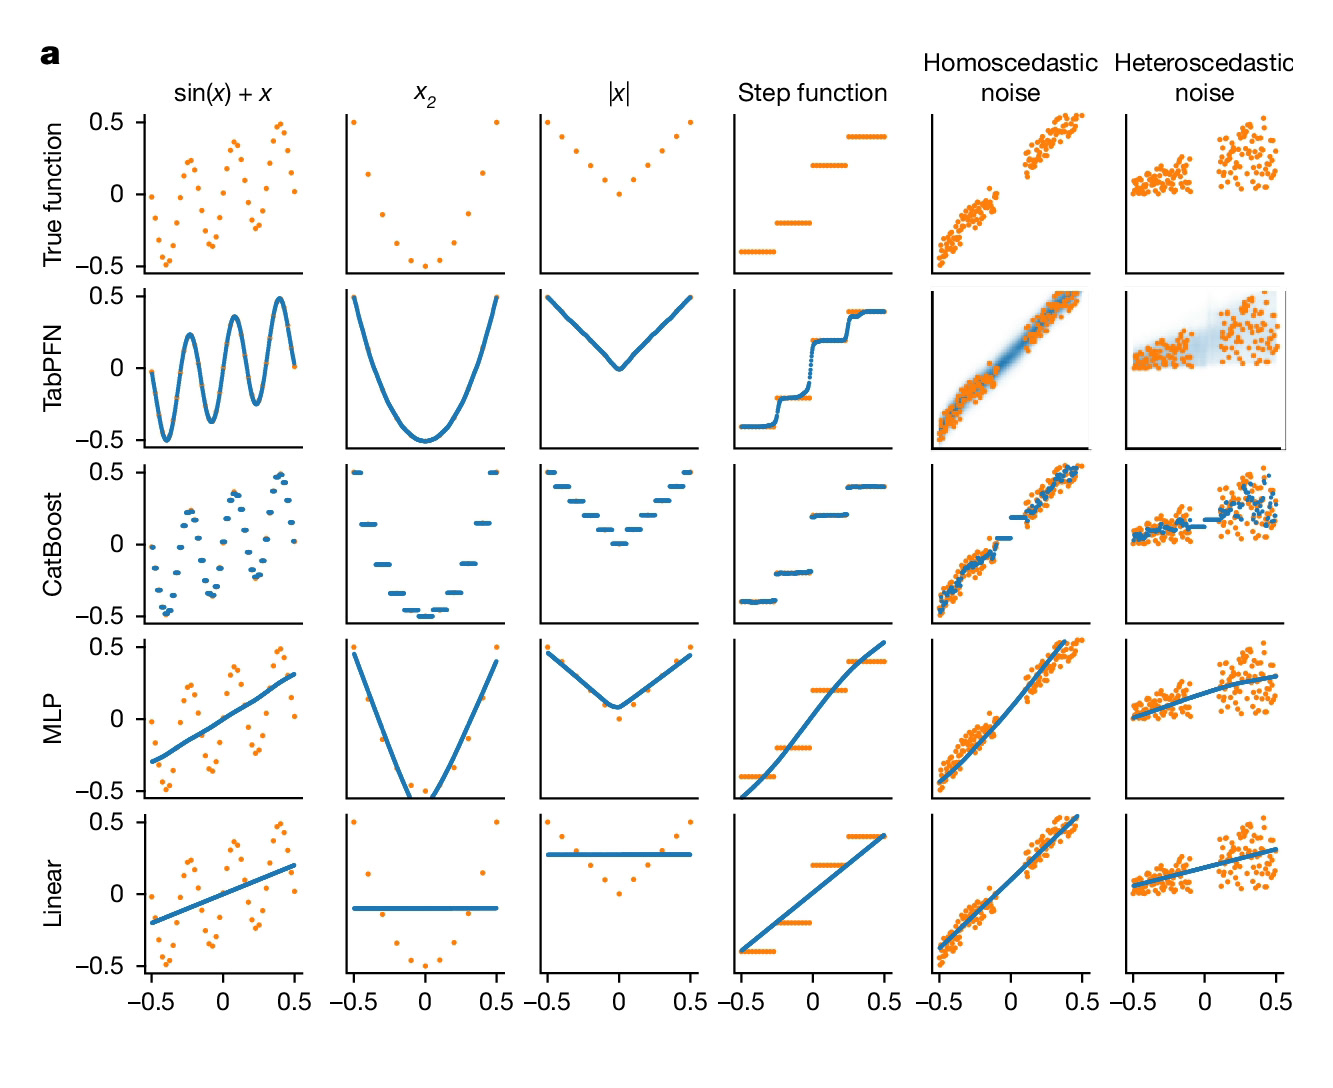
Hình 22. Dự đoán của TabPFN, CatBoost, MLP và mô hình tuyến tính trên sáu hàm một chiều, bao gồm hai hàm có nhiễu đồng nhất (homoscedastic) và không đồng nhất (heteroscedastic). Màu cam: dữ liệu thật, màu xanh: dự đoán. Nguồn: Hollmann et al., Nature 637 (2025), Fig. 3a, CC BY 4.0.
Với hàm có nhiễu không đồng nhất (cột cuối), TabPFN dự đoán được độ rộng của phân phối thay đổi theo , nhờ đầu ra là một phân phối.
9.6. Các benchmark khác
Bài báo còn báo cáo kết quả trên:
- Benchmark của Grinsztajn et al. (7 bộ dữ liệu có biến danh mục, 15 bộ chỉ có biến số) và TabZilla (102 bộ dữ liệu). TabPFN có điểm trung bình cao nhất trong các phương pháp được so sánh.
- Năm cuộc thi Kaggle Tabular Playground Series mùa 3 có dưới 10.000 hàng huấn luyện. TabPFN mặc định cho kết quả tốt hơn CatBoost mặc định ở cả năm cuộc thi.
9.7. TabPFN (PHE) so với AutoGluon
AutoGluon là hệ AutoML kết hợp nhiều mô hình (cây, mạng nơ-ron, k-NN) bằng stacking và ensemble. Nhóm tác giả xây dựng một biến thể gọi là TabPFN (PHE), viết tắt của post hoc ensemble: chạy nhiều cấu hình TabPFN khác nhau rồi kết hợp kết quả. Trên benchmark phân loại, TabPFN (PHE) đạt ROC AUC chuẩn hóa 0,971, AutoGluon đạt 0,914, TabPFN mặc định đạt 0,939. Xét theo từng bộ dữ liệu, TabPFN (PHE) cho kết quả tốt hơn AutoGluon trên khoảng 76% số bộ phân loại và khoảng 68% số bộ hồi quy.
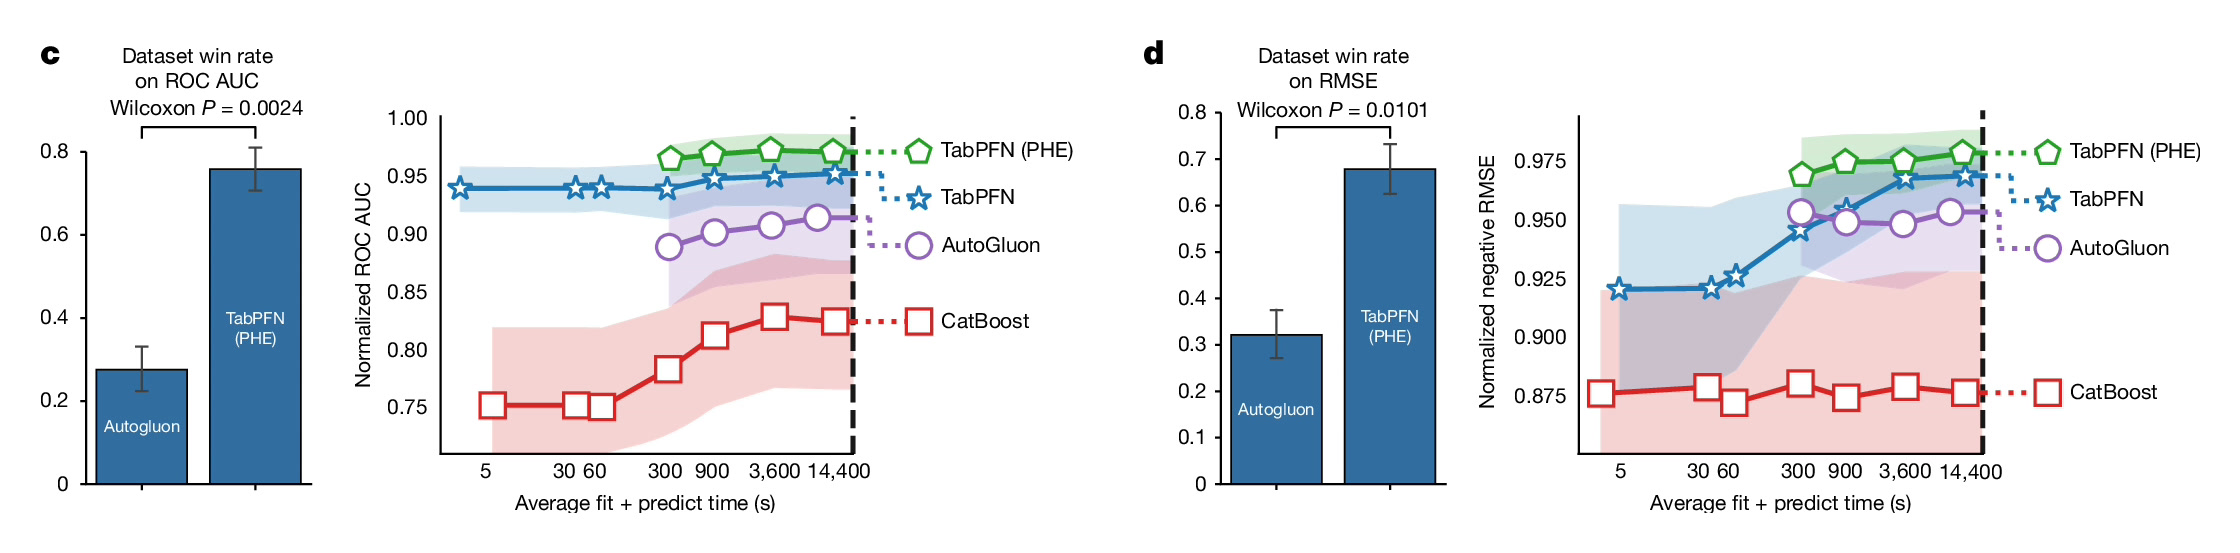
Hình 23. (c) Phân loại: tỉ lệ bộ dữ liệu mỗi phương pháp thắng, và ROC AUC chuẩn hóa theo thời gian. (d) Hồi quy, trình bày tương tự với RMSE. Nguồn: Hollmann et al., Nature 637 (2025), Fig. 5c,d, CC BY 4.0.
9.8. TabPFN-2.5 trên TabArena
TabArena là một benchmark được duy trì liên tục cho dữ liệu bảng, chứa bộ dữ liệu đến 100.000 mẫu huấn luyện. Theo báo cáo kỹ thuật TabPFN-2.5, trên phiên bản rút gọn TabArena-Lite:
- TabPFN-2.5 xếp hạng đầu và có điểm cao hơn các mô hình cây đã tinh chỉnh.
- Kết quả ngang AutoGluon 1.4 với ngân sách tinh chỉnh 4 giờ (AutoGluon 1.4 bao gồm TabPFN v2 trong tổ hợp của nó).
- So với XGBoost ở cấu hình mặc định, TabPFN-2.5 mặc định thắng trên 100% bộ phân loại cỡ nhỏ và vừa (đến 10.000 mẫu, 500 đặc trưng), 87% bộ dữ liệu lớn hơn (đến 100.000 mẫu, 2.000 đặc trưng) và 85% bài hồi quy.
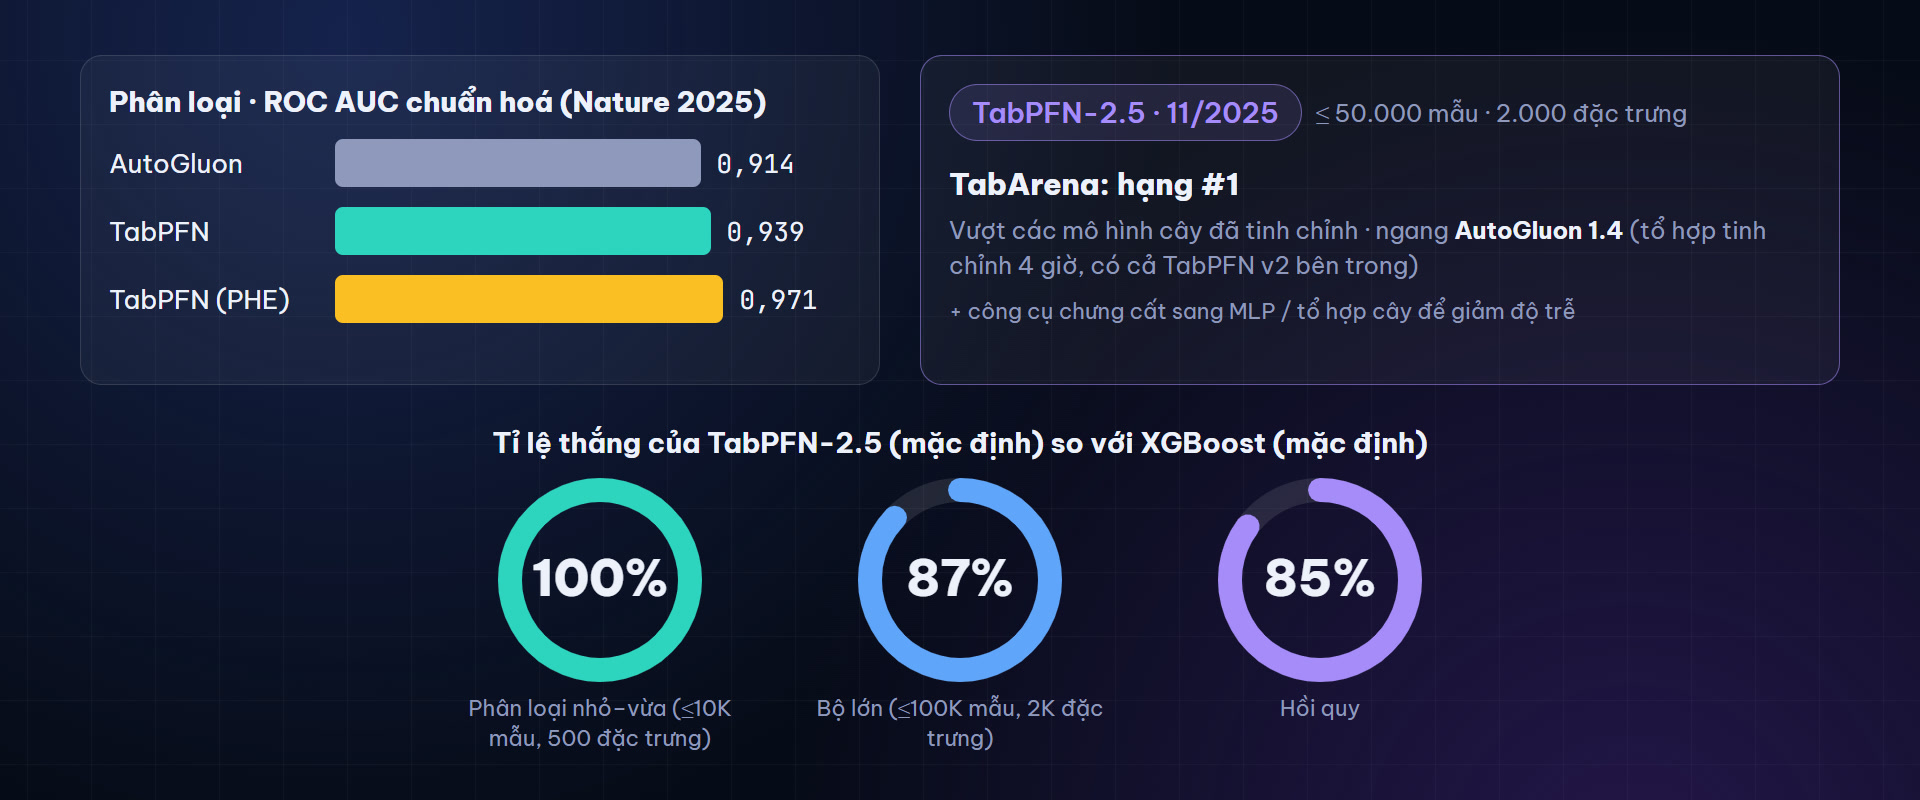
Hình 24. Trên: ROC AUC chuẩn hóa của AutoGluon, TabPFN và TabPFN (PHE) trong bài báo Nature. Dưới: tỉ lệ thắng của TabPFN-2.5 mặc định so với XGBoost mặc định, theo báo cáo kỹ thuật TabPFN-2.5. Hình vẽ lại từ số liệu công bố.
9.9. Cách đọc các kết quả này
Trước khi dùng các con số trên để chọn mô hình:
- Phần lớn kết quả do chính nhóm tác giả công bố. Bài báo Nature đã qua bình duyệt, nhưng báo cáo TabPFN-2.5 và TabPFN-3 là báo cáo kỹ thuật của công ty phát triển sản phẩm. TabArena là benchmark độc lập, nhưng việc cấu hình mô hình vẫn do nhóm tác giả thực hiện.
- So sánh với cấu hình mặc định của XGBoost là so sánh dễ. Tỉ lệ thắng 100% trước XGBoost mặc định có ý nghĩa khác với tỉ lệ thắng trước XGBoost đã tinh chỉnh.
- Benchmark chọn lọc theo giới hạn của mô hình. Các bộ dữ liệu được chọn nằm trong vùng TabPFN được thiết kế để xử lý. Kết quả không áp dụng cho bảng có hàng triệu dòng hoặc hàng chục nghìn cột (với v2).
Cách đánh giá đáng tin nhất vẫn là chạy TabPFN và baseline trên dữ liệu của chính mình, với cùng một quy trình chia dữ liệu.
10. Các khả năng khác ngoài dự đoán
Vì TabPFN học phân phối có điều kiện của một cột dựa trên các cột khác, nó có thể được dùng cho một số tác vụ khác ngoài phân loại và hồi quy.
- Ước lượng mật độ và phát hiện bất thường: mật độ đồng thời được phân rã thành tích các phân phối có điều kiện, , mỗi thừa số được TabPFN ước lượng. Kết quả được lấy trung bình trên 24 thứ tự đặc trưng để giảm phương sai. Mẫu có mật độ thấp có thể được xem là bất thường.
- Sinh dữ liệu tổng hợp: dùng cùng phân rã trên để lấy mẫu lần lượt từng đặc trưng.
- Embedding: biểu diễn ở ô mục tiêu sau lớp cuối có thể dùng làm vector đặc trưng cho các mô hình khác. Trên bộ dữ liệu chữ số viết tay mfeat-factors, các lớp tách biệt rõ hơn khi chiếu embedding bằng PCA so với chiếu dữ liệu gốc.
- Fine-tuning: mạng có thể được huấn luyện tiếp trên một họ bộ dữ liệu cụ thể. Bài báo thử với các đường sin có độ lệch pha khác nhau và cho thấy mức cải thiện lớn hơn khi dữ liệu fine-tune gần với dữ liệu kiểm thử.
- Diễn giải bằng SHAP: vì TabPFN tương thích scikit-learn, có thể dùng SHAP để xem ảnh hưởng của từng đặc trưng. Trên bộ dữ liệu "Default of Credit Card Clients", nhóm tác giả cho biết các hàm ảnh hưởng mà TabPFN học được đơn giản hơn của CatBoost.
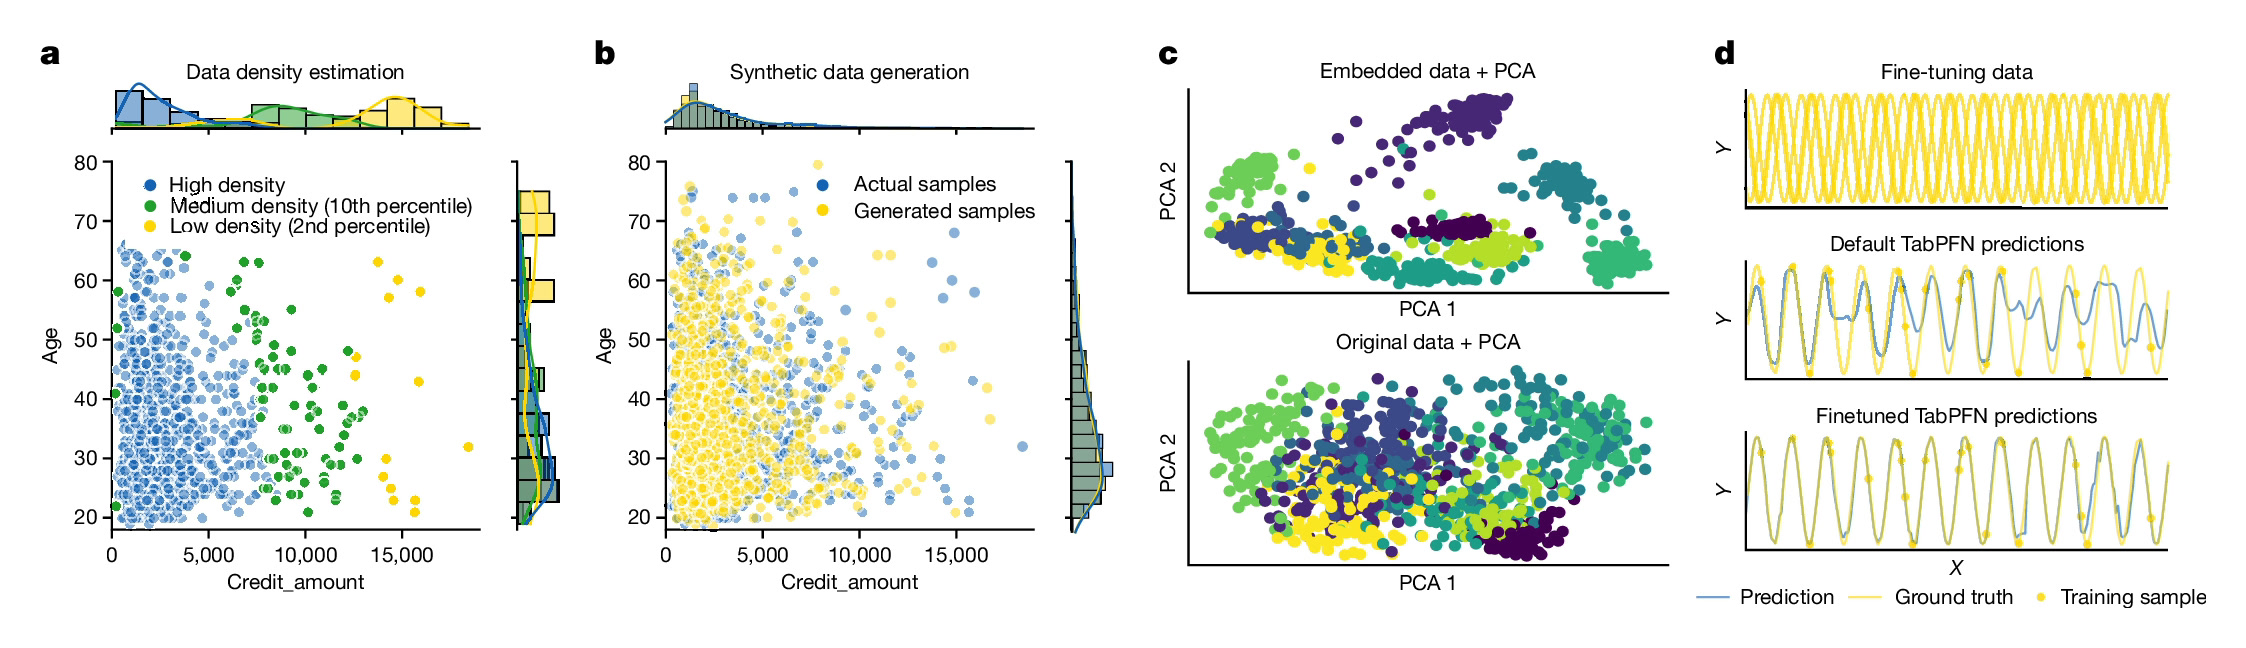
Hình 25. (a) Ước lượng mật độ trên bộ dữ liệu German Credit. (b) Sinh mẫu tổng hợp. (c) Embedding của TabPFN so với dữ liệu gốc, chiếu bằng PCA, trên bộ mfeat-factors. (d) Dự đoán trước và sau khi fine-tune trên các đường sin. Nguồn: Hollmann et al., Nature 637 (2025), Fig. 6, CC BY 4.0.
11. Ứng dụng thực tế
Thông tin về ứng dụng hiện chủ yếu đến từ báo cáo của Prior Labs và các bài báo khoa học dùng TabPFN làm công cụ. Dưới đây là các trường hợp có nguồn công khai:
- Y tế: báo cáo TabPFN-2.5 cho biết đây là lĩnh vực có nhiều ứng dụng nhất, với hơn 50 công bố trong ung thư học, thần kinh học, tim mạch và dược lý. Một lý do là dữ liệu lâm sàng thường có vài trăm đến vài nghìn bệnh nhân, đúng vùng TabPFN được thiết kế.
- Oxford Cancer Analytics dùng TabPFN để phân tích dữ liệu proteomics trong nghiên cứu bệnh phổi.
- Hitachi được cho là dùng TabPFN cho bảo trì dự đoán trên mạng lưới đường sắt.
- Tài chính: case study với Taktile so sánh TabPFN với mô hình cây trên dữ liệu phát hiện gian lận khi mở tài khoản. Báo cáo nêu ưu điểm là xử lý giá trị thiếu và ngoại lai mà không cần điền khuyết, đồng thời ghi nhận độ trễ suy luận cao và giới hạn kích thước dữ liệu.
- Nghiên cứu khoa học: chemoproteomics, metagenomics, phân loại rủi ro bảo hiểm, xét nghiệm máu cho ung thư tụy.
- Cuộc thi: đội thắng cuộc thi PREPARE của DrivenData dùng TabPFN để tạo đặc trưng cho mô hình cây.
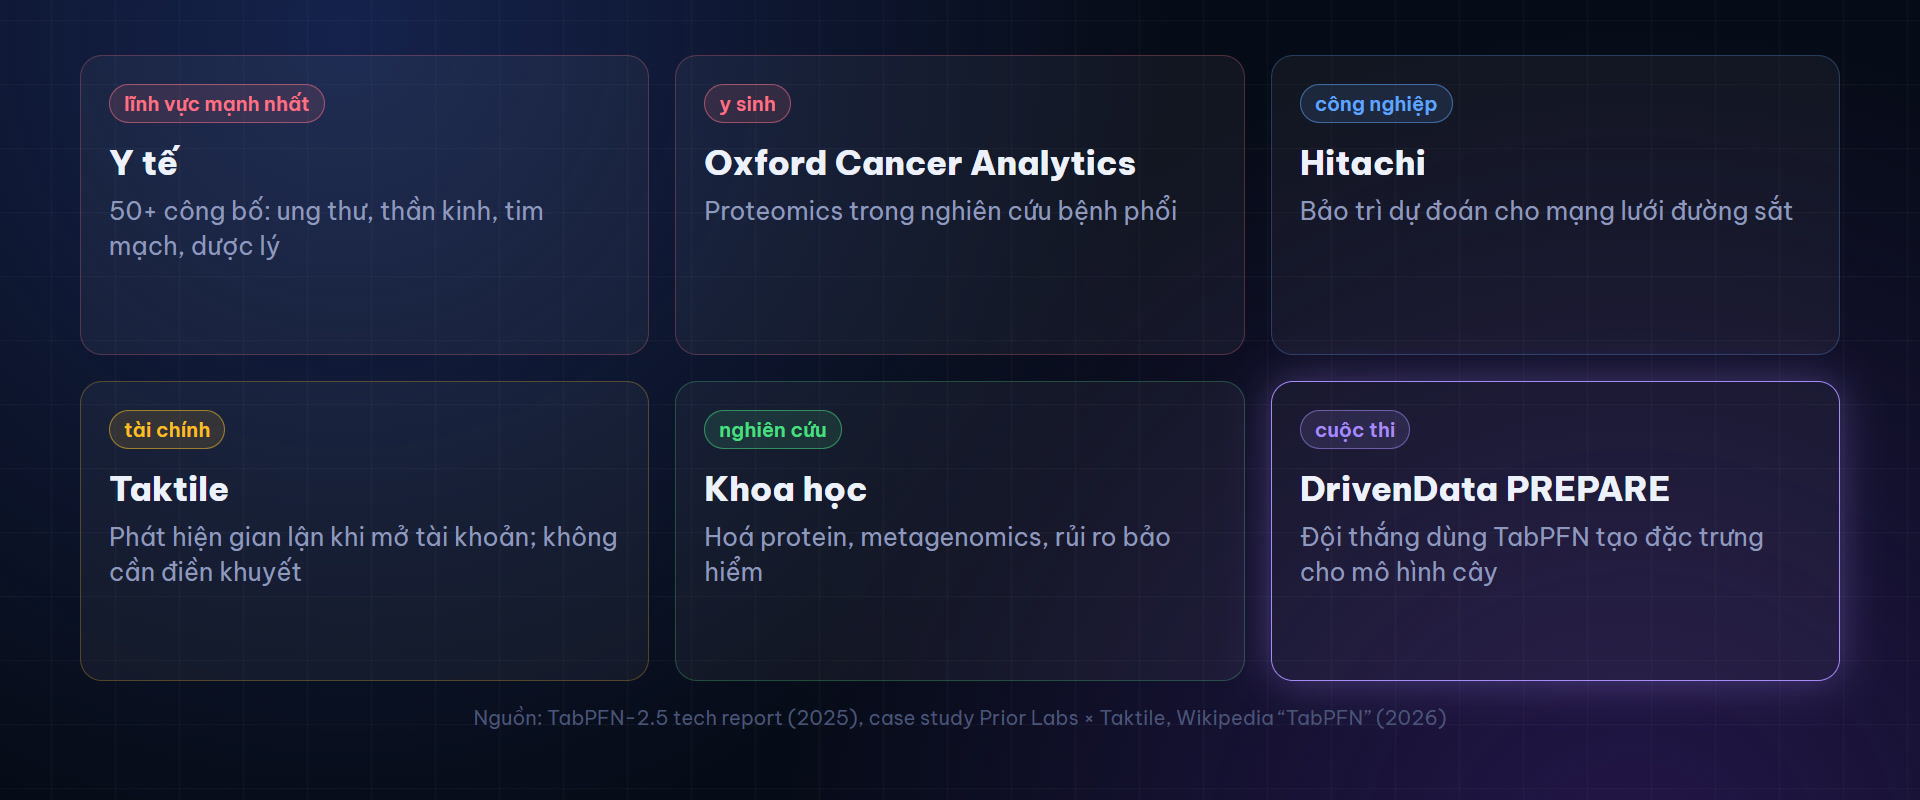
Hình 26. Một số trường hợp ứng dụng TabPFN có nguồn công khai. Nguồn: báo cáo TabPFN-2.5 (2025), case study Prior Labs và Taktile, Wikipedia "TabPFN" (2026).
Ở cuộc thi PREPARE, TabPFN được dùng làm bước tạo đặc trưng cho mô hình cây, tức là hai họ mô hình được kết hợp trong cùng một pipeline.
12. Giới hạn
12.1. Độ trễ suy luận
Mô hình cây sau khi huấn luyện dự đoán rất nhanh vì chỉ cần duyệt các cây. TabPFN phải chạy attention trên toàn bộ tập huấn luyện mỗi lần dự đoán (trừ khi dùng bộ nhớ đệm). Bài báo ghi nhận với bảng 10.000 hàng và 10 cột, TabPFN mất khoảng 0,2 giây mỗi lần dự đoán trên GPU (0,6 giây không có GPU), trong khi CatBoost mặc định mất 0,0002 giây, chênh lệch khoảng 1.000 lần.
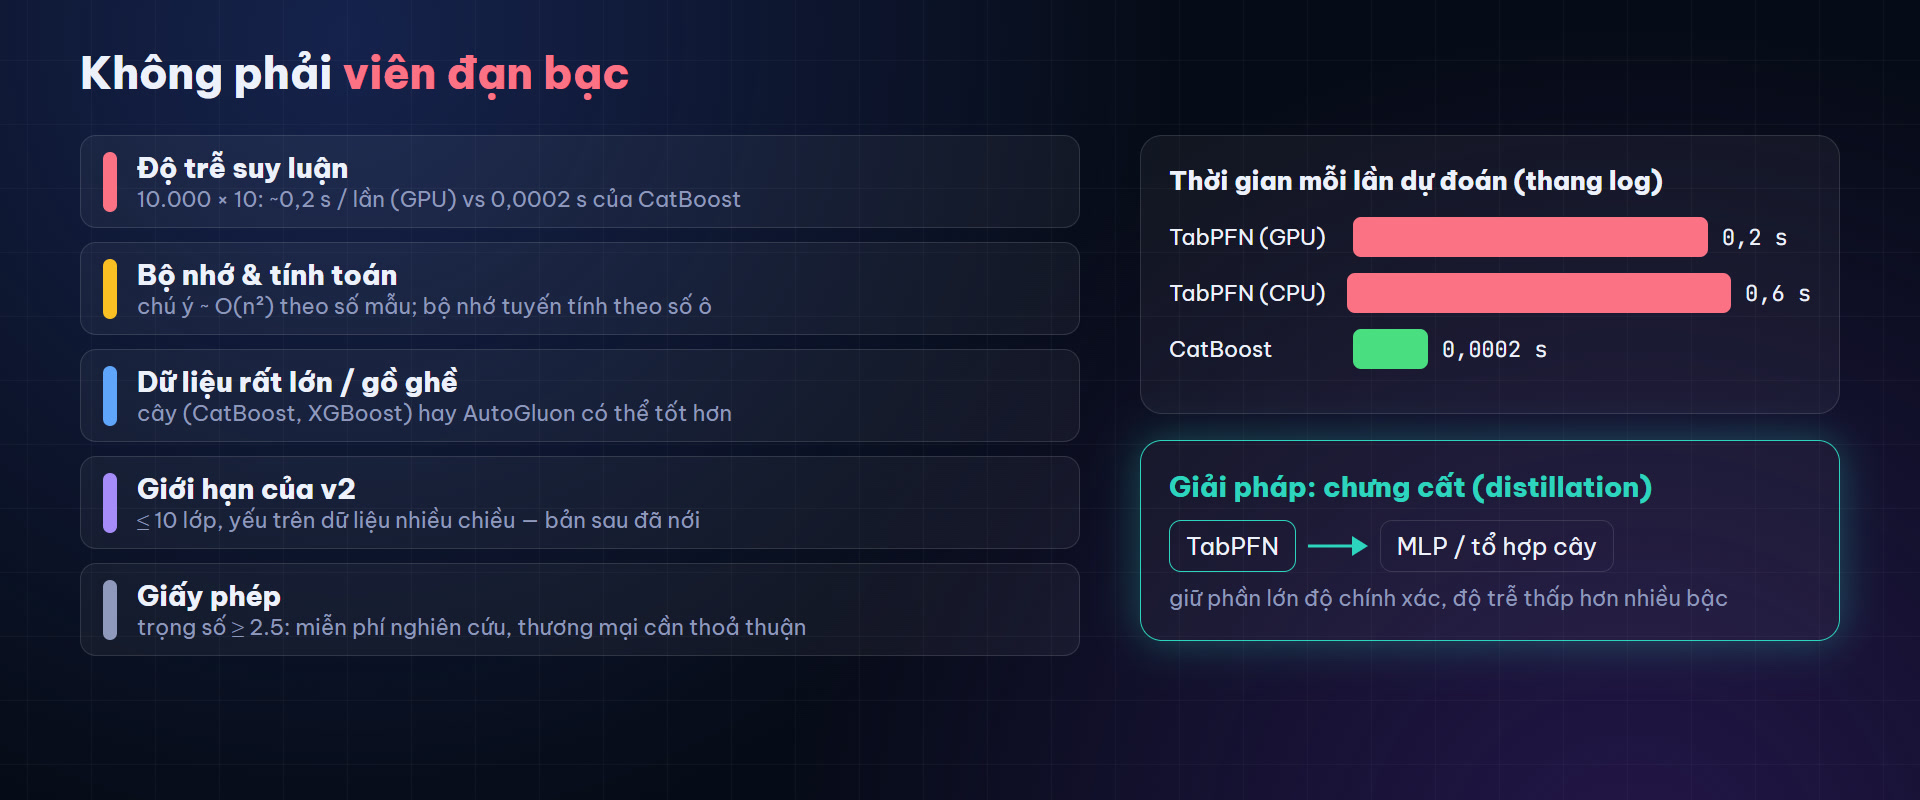
Hình 27. Các giới hạn chính và thời gian mỗi lần dự đoán so với CatBoost (thang logarit).
Với các hệ thống cần trả lời trong vài mili giây trên CPU, ví dụ chấm điểm giao dịch theo thời gian thực, đây là giới hạn đáng kể. TabPFN-2.5 giới thiệu công cụ chưng cất (distillation) để chuyển TabPFN thành một MLP hoặc một tổ hợp cây nhỏ, giữ phần lớn độ chính xác với độ trễ thấp hơn nhiều bậc.
12.2. Kích thước dữ liệu và bộ nhớ
Chi phí attention tăng theo bình phương số hàng. Với v2, bài báo chỉ đánh giá đến 10.000 mẫu và nói rõ việc mở rộng ra ngoài phạm vi này cần nghiên cứu thêm. Một nghiên cứu năm 2025 ghi nhận TabPFN v2 cho kết quả kém trên dữ liệu nhiều chiều và quy mô lớn. Các phiên bản sau (2.5, 3) đã nâng giới hạn, nhưng khi dữ liệu lớn, mô hình cây vẫn có lợi thế về chi phí, và lợi thế về chất lượng của TabPFN có xu hướng giảm khi số mẫu tăng.
12.3. Hồi quy với hàm không trơn
Bài báo nhận định với dữ liệu lớn và các bài hồi quy có hàm mục tiêu rất không trơn, CatBoost, XGBoost hoặc AutoGluon nhiều khả năng cho kết quả tốt hơn.
12.4. Giới hạn số lớp
Phiên bản 2 chỉ hỗ trợ trực tiếp tối đa 10 lớp, do giới hạn của prior. Bài toán nhiều lớp hơn cần các kỹ thuật chia nhỏ như one-vs-rest hoặc mã hóa đầu ra.
12.5. Phụ thuộc vào prior
Mọi giả định của TabPFN nằm trong prior. Nếu dữ liệu thật có cấu trúc khác xa những gì prior sinh ra, ví dụ chuỗi thời gian có phụ thuộc giữa các hàng, hoặc đặc trưng là văn bản dài, mô hình không có cơ sở để dự đoán tốt. Mô hình cây cũng có giả định riêng, nhưng giả định đó đơn giản và dễ kiểm tra hơn.
12.6. Giấy phép
Mã nguồn của thư viện được phát hành theo giấy phép Apache 2.0. Trọng số của TabPFN v2 được phát hành theo Apache 2.0 kèm yêu cầu ghi nhận nguồn. Từ phiên bản 2.5, trọng số được phát hành theo giấy phép cho phép dùng cho nghiên cứu và đánh giá nội bộ; muốn đưa vào sản phẩm thương mại thì cần thỏa thuận riêng với Prior Labs.
13. Khi nào nên dùng TabPFN
Phù hợp khi:
- Bảng có từ vài chục đến vài chục nghìn hàng, và cần một kết quả tốt mà không muốn đầu tư thời gian tinh chỉnh.
- Cần xác suất được hiệu chỉnh tốt hoặc cần toàn bộ phân phối dự đoán, ví dụ để ước lượng độ bất định.
- Dữ liệu có giá trị thiếu, ngoại lai, cột danh mục, và không muốn viết nhiều bước tiền xử lý.
- Cần một baseline để đánh giá nhanh một bộ dữ liệu trước khi đầu tư vào mô hình phức tạp hơn.
Cần cân nhắc khi:
- Hệ thống yêu cầu độ trễ rất thấp trên CPU.
- Dữ liệu có hàng triệu dòng trở lên và không có GPU phù hợp.
- Dữ liệu có cấu trúc khác bảng độc lập, như chuỗi thời gian hay dữ liệu quan hệ.
- Sản phẩm thương mại cần dùng trọng số từ phiên bản 2.5 trở đi.
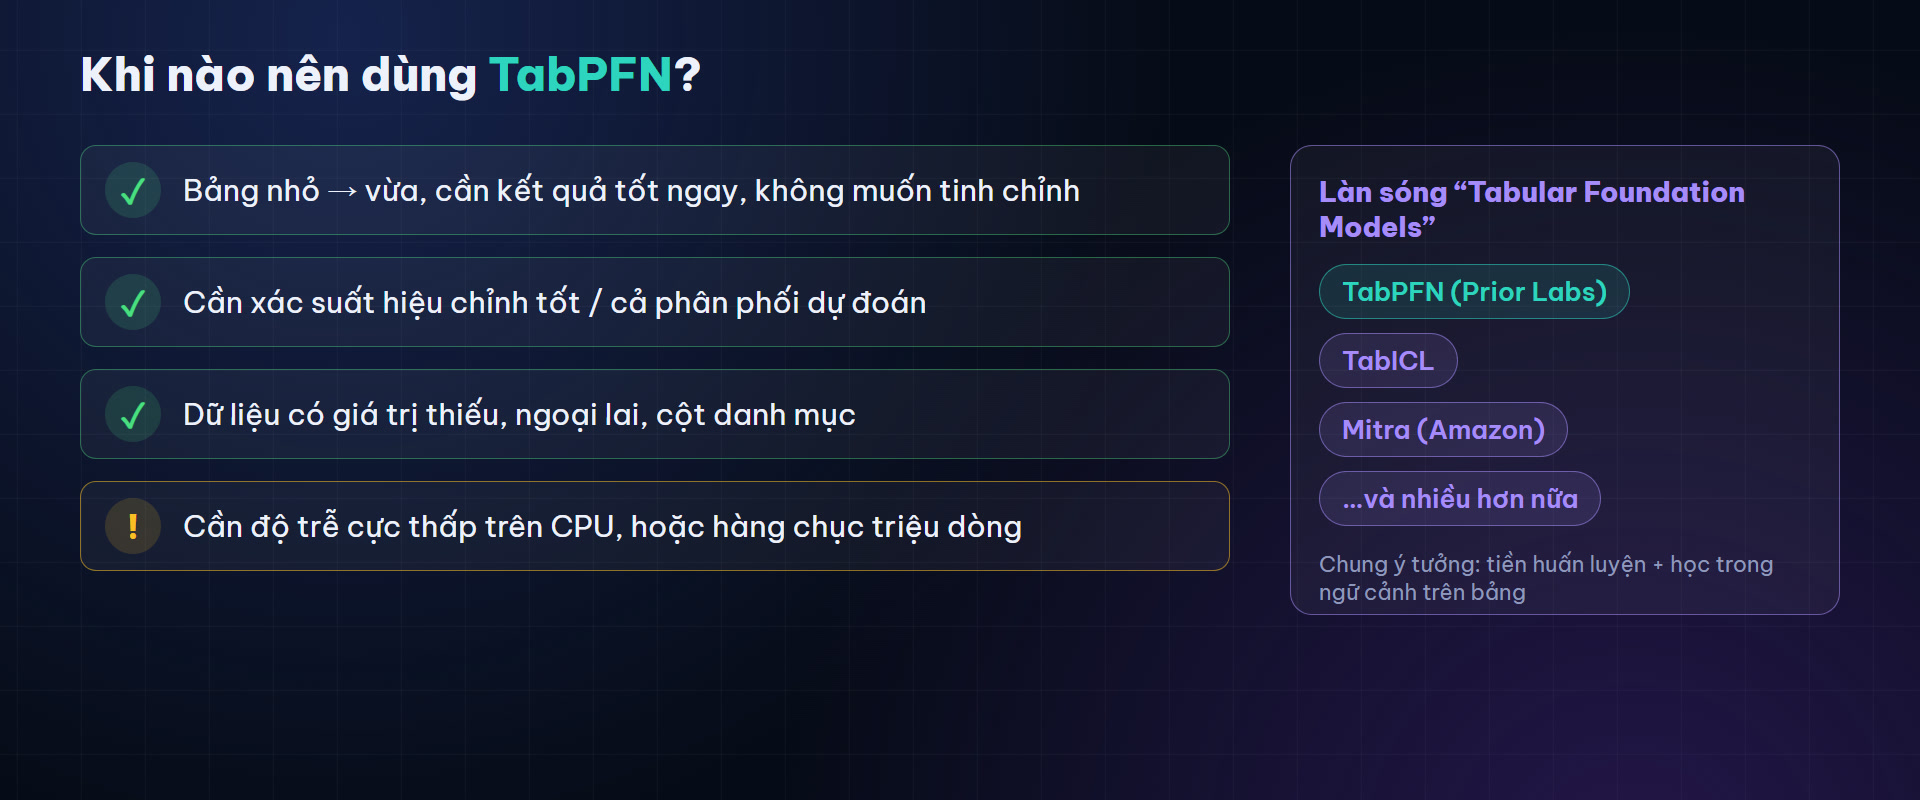
Hình 28. Tóm tắt các trường hợp nên dùng và cần cân nhắc. Bên phải: một số mô hình nền tảng khác cho dữ liệu bảng.
Cùng hướng với TabPFN còn có TabICL, dùng kiến trúc khác để mở rộng học trong ngữ cảnh lên bảng lớn hơn. Mitra của Amazon và LimiX là các mô hình nền tảng khác cho dữ liệu bảng. Báo cáo TabPFN-2.5 có so sánh với TabICL và LimiX trên các tập con của TabArena. Hướng nghiên cứu này còn mới, và thứ hạng giữa các mô hình có thể thay đổi nhanh.
14. Kết luận
TabPFN chuyển trọng tâm của học máy trên dữ liệu bảng từ việc thiết kế thuật toán sang việc thiết kế phân phối dữ liệu. Thay vì viết ra một thuật toán và tinh chỉnh nó cho từng bộ dữ liệu, nhóm tác giả mô tả những loại dữ liệu có thể gặp bằng một prior dựa trên mô hình nhân quả cấu trúc, rồi để một Transformer học thuật toán dự đoán tối ưu cho prior đó. Kiến trúc attention hai chiều, coi mỗi ô là một token và cho hàng kiểm thử chỉ nhìn hàng huấn luyện, phù hợp với tính chất của bảng: không có thứ tự hàng, không có thứ tự cột, và các dự đoán độc lập với nhau.
Trên các benchmark dữ liệu nhỏ, TabPFN đạt điểm cao hơn mô hình cây đã tinh chỉnh với thời gian ngắn hơn nhiều. Đổi lại, mô hình có độ trễ suy luận cao hơn, bị giới hạn về kích thước dữ liệu, và chất lượng phụ thuộc vào việc prior có phản ánh đúng dữ liệu thật hay không.
Với người làm thực tế, cách dùng hợp lý là đưa TabPFN vào danh sách các mô hình cần thử, đặc biệt khi dữ liệu nhỏ, rồi so sánh với mô hình cây trên chính dữ liệu của mình. Với người làm nghiên cứu, phần còn nhiều việc để làm là prior: tìm những cấu trúc trong dữ liệu thật mà prior hiện tại chưa sinh ra, và đo xem bổ sung chúng làm mô hình thay đổi ra sao.
Tài liệu đọc thêm
Related Articles
Discover more articles related to this topic
Ngôn Ngữ, Xác Suất và Nhận Thức – phương trình công nghệ trong lịch sử mô hình hóa ngôn ngữ của nhân loại
Khám phá hành trình tiến hóa vĩ đại của mô hình ngôn ngữ, nơi ngôn ngữ, xác suất và nhận thức đan xen trong suốt tiến trình lịch sử công nghệ: từ những mô hình thống kê N-gram giản đơn, đến mạng nơ-ron và RNN, rồi bứt phá với LSTM, Seq2Seq và Attention; từ cuộc cách mạng Transformer mở đường cho BERT, GPT và vô số biến thể, đến kỷ nguyên LLM với khả năng sáng tạo, suy luận, đa phương thức. Đây không chỉ là câu chuyện kỹ thuật, mà còn là bản trường ca triết học về cách máy móc phản chiếu tư duy con người và gợi mở viễn cảnh trí tuệ nhân tạo tổng quát.
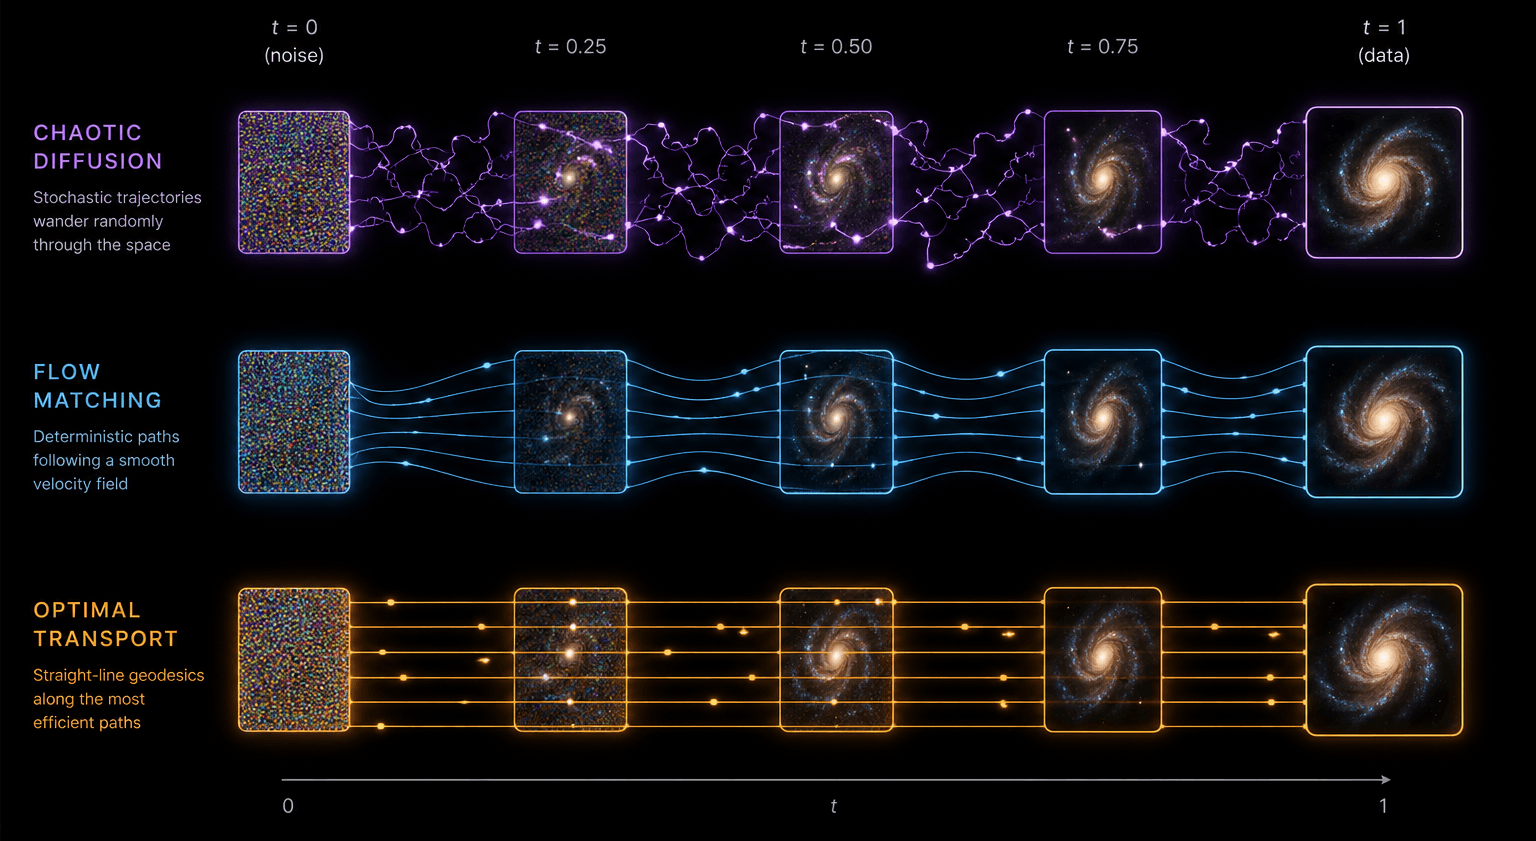
Diffusion vs Flow Matching vs Optimal Transport
Phân tích tổng quan sự khác nhau và điểm tương đồng giữa Diffusion, Flow Matching và Optimal Transport dưới góc nhìn chuyển động của phân phối xác suất, từ hàm mất mát đến quá trình lấy mẫu.
MemVerse: Multimodal Memory và con đường hướng tới Lifelong Learning Agents
Phân tích MemVerse – một framework bộ nhớ đa phương thức cho AI Agents học tập suốt đời, kết hợp Knowledge Graph truy xuất và Parametric Memory để giải quyết bài toán catastrophic forgetting, tối ưu suy luận đa phương thức và tương tác dài hạn.
Fractal Dimension: Khi chiều không gian vượt thoát khỏi khuôn khổ số nguyên
Khám phá chiều fractal – một khái niệm đột phá trong hình học, vượt ra ngoài khuôn khổ số nguyên để mô tả sự phức tạp của tự nhiên. Bài viết đi sâu vào lịch sử, cơ sở toán học và vô vàn ứng dụng của fractal trong sinh học, vật lý, kinh tế và đặc biệt là khoa học máy tính và AI.
Discover all 7 articles in our blog